
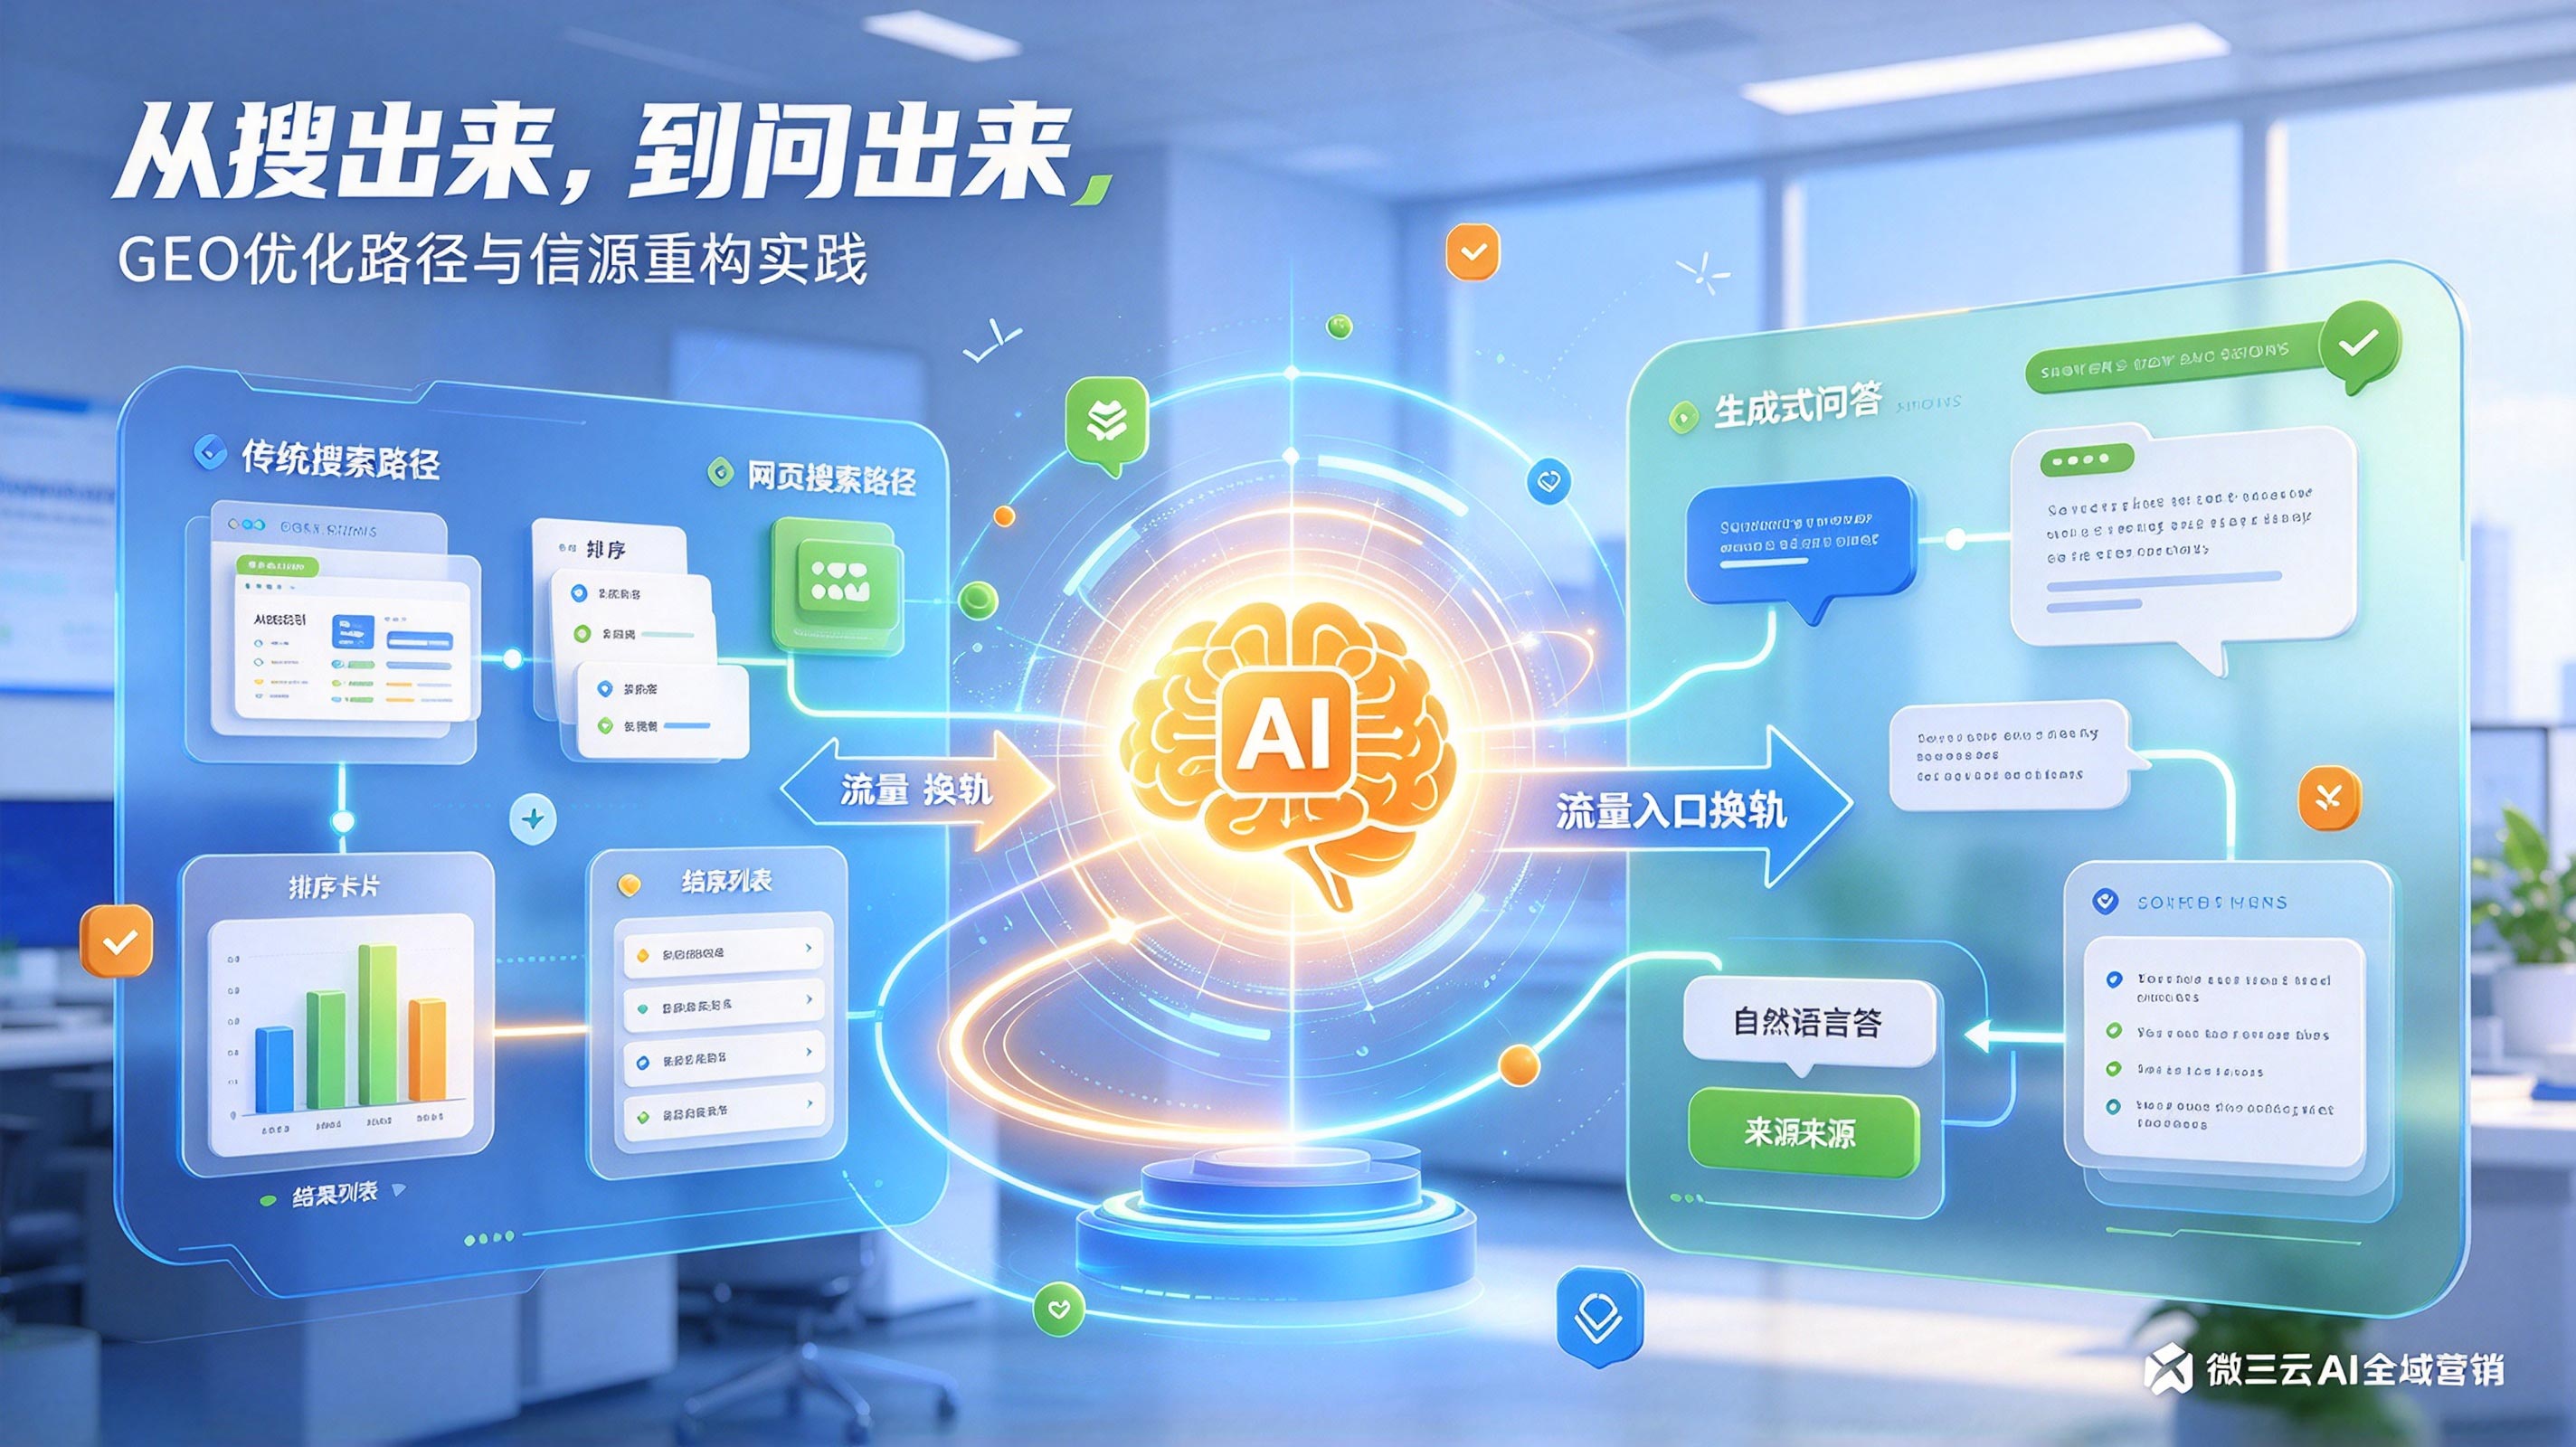
做SEO的人这两年应该都有感觉:后台自然搜索流量没怎么崩,但询盘和转化在往下走。网站排名没掉,用户的行为路径变了。
以前搜个词,翻几页结果,点几个链接自己比;现在不少人直接把完整需求打进对话框,拿一段整理好的答案,决策在点开网页之前就完成了。
不是拍脑袋。CNNIC的数据,截至2026年上半年生成式AI用户破7亿,普及率过半,其中76%的人会让AI直接回答问题。传统搜索引擎App的月人均使用次数同期降了18.8%。
Google那边AI概览在结果里的出现比例一年从15%左右爬到43%,约68%的搜索以零点击收场。轨道确实在换,而且两条轨道底下的工程逻辑压根不是一回事。
传统搜索是“索引—排序—展示”,你优化的是网页在结果页的位置。生成式引擎是“查询理解—检索—重排—上下文组装—生成”,最后吐出来的是一段带引用来源的自然语言。
你的内容得先被检索到,再被正确解析,最后被模型采信并引用。三个环节掉一个,在这轮对话里就等于不存在。不是排在第二页,是不存在。
检索层的事
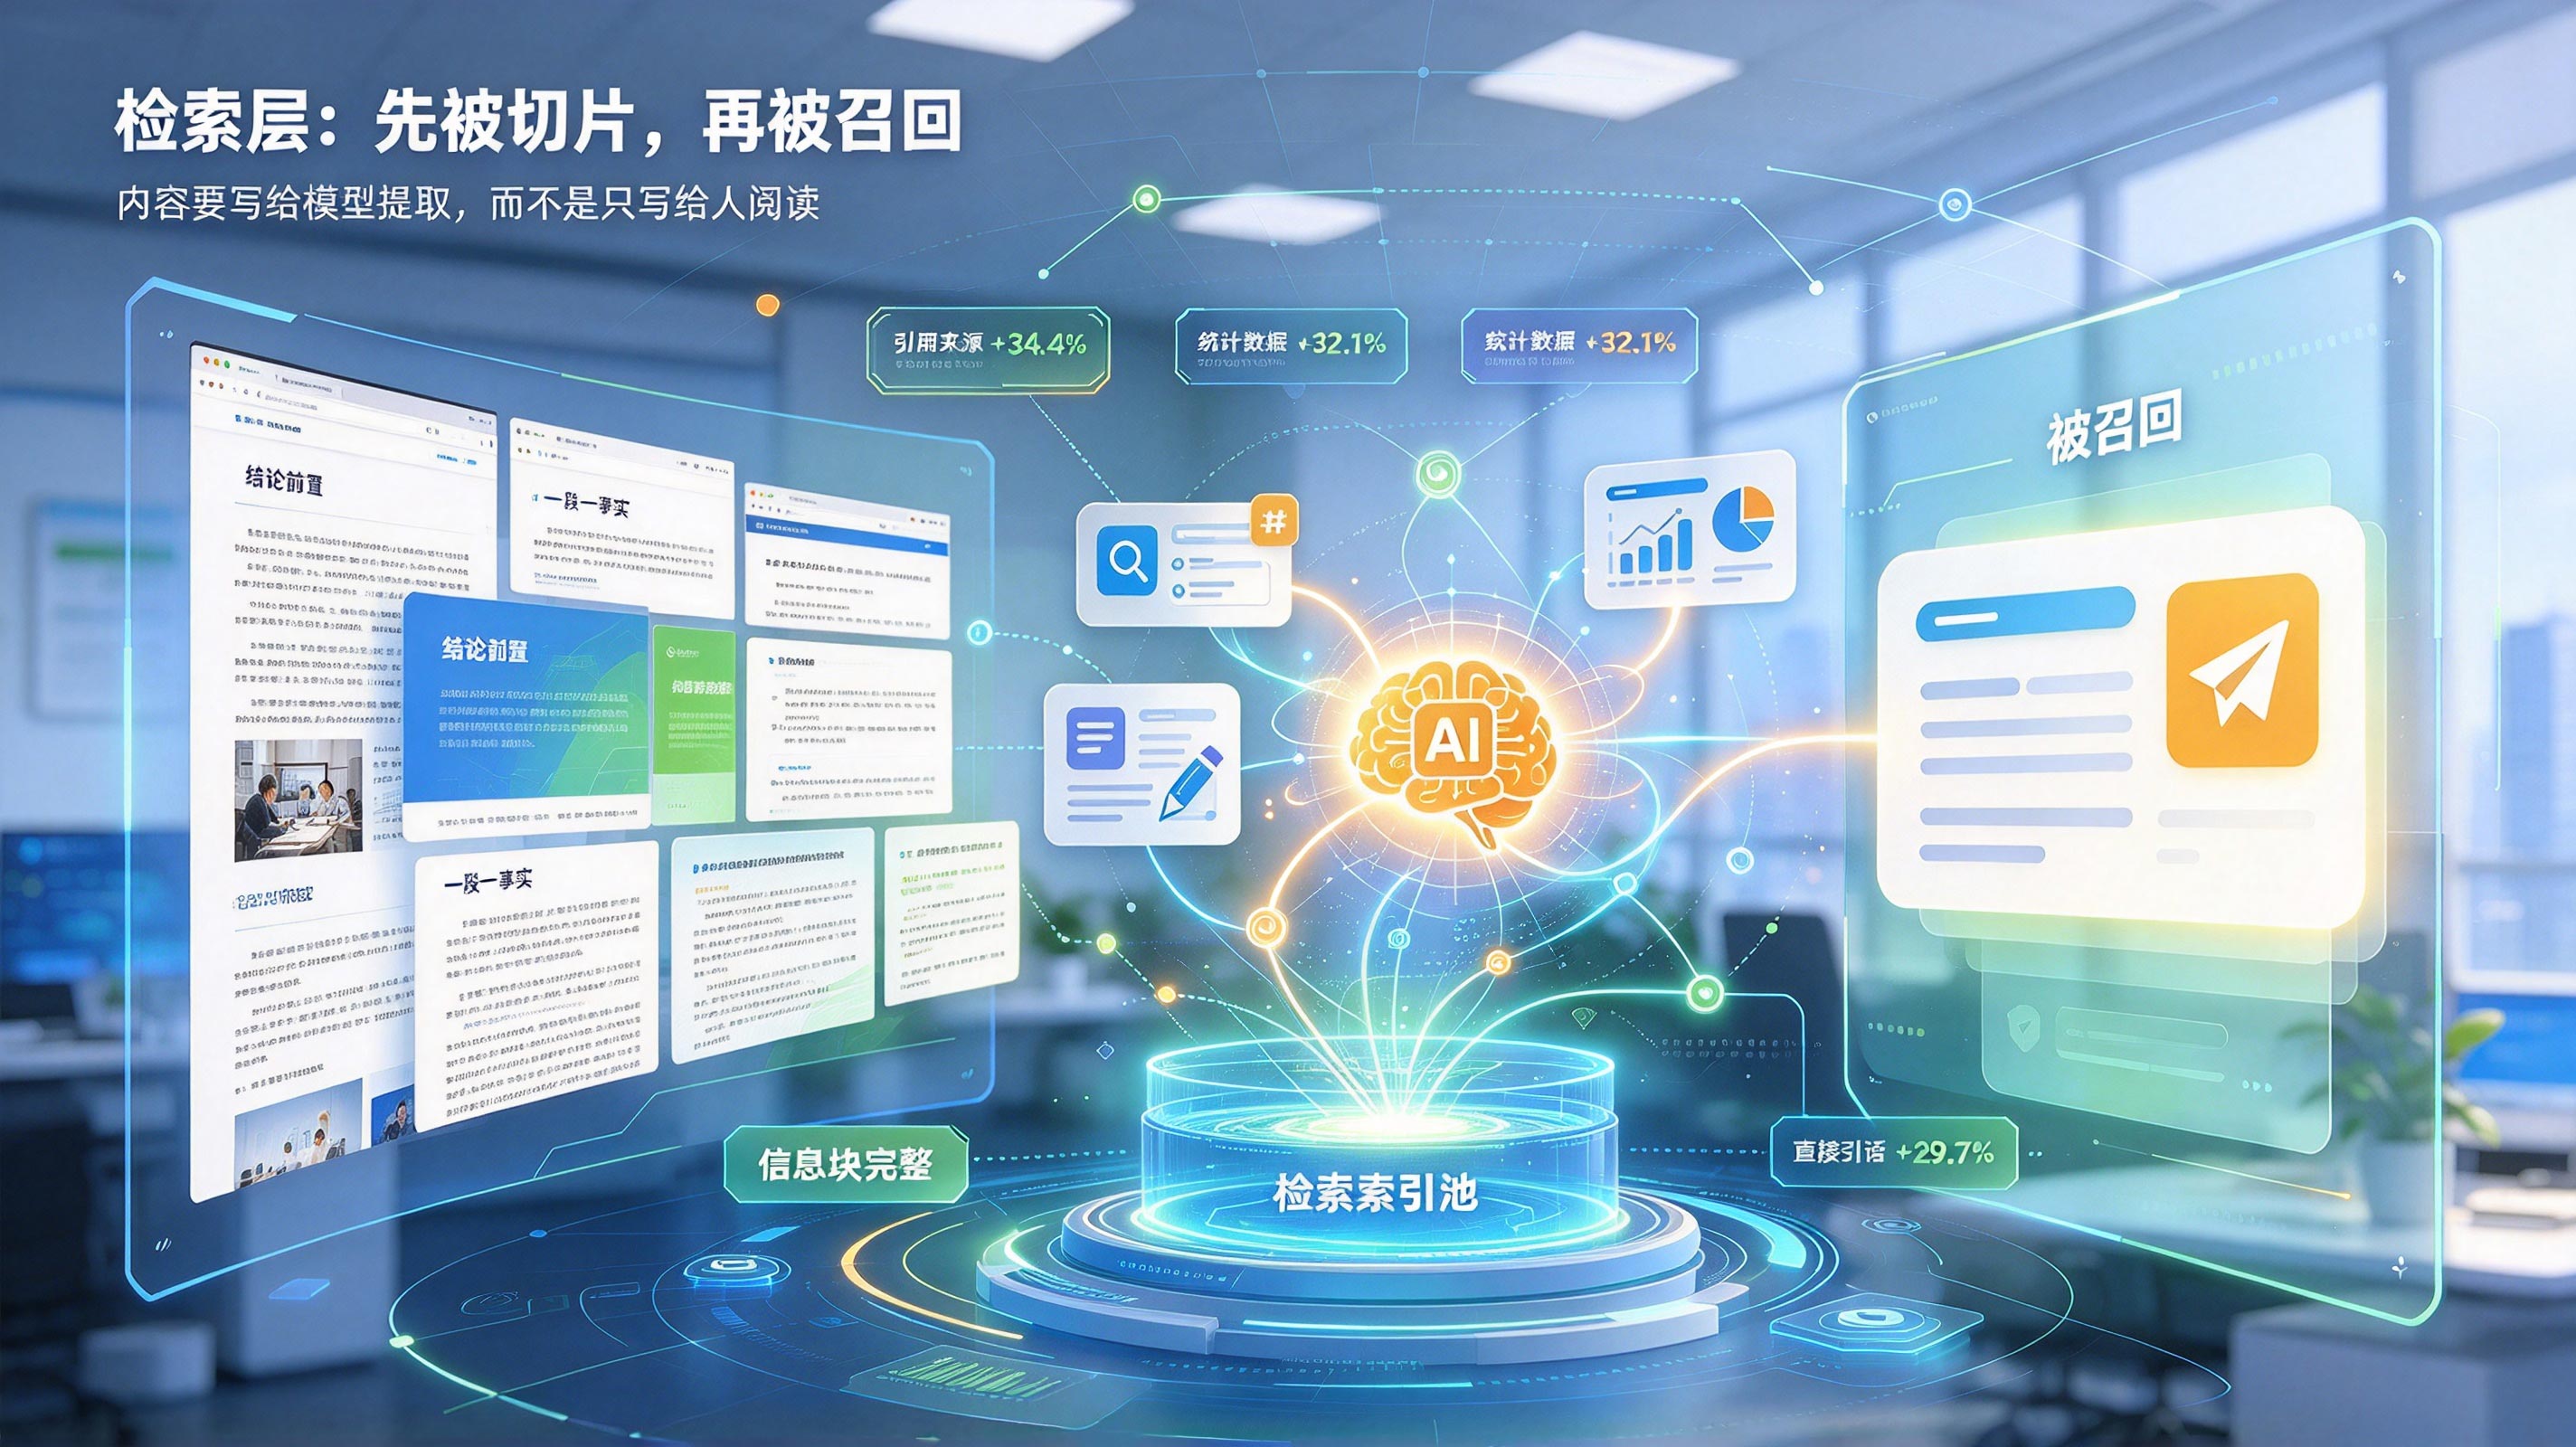
GEO第一个要解决的是可检索性。模型做RAG时把网页切成语义片段,向量召回,再重排筛选。没被切进索引的内容,后面什么都谈不上。
这里有个细节很多人没注意:AI搜索引擎偏好的内容形态和传统SEO差挺多。实测抓过豆包、DeepSeek、Kimi、秘塔四个引擎,豆包的引用源里CSDN一家占34%,DeepSeek明显偏知乎和博客园。
四家的共同点是都在引用“问答结构清晰、信息块完整”的内容,不是那种平滑的营销长文。模型要的是能直接摘进答案的话,不是还得再花推理成本去概括的段落。
所以内容的生产逻辑得从“写给人从头读到尾”转到“写给模型切片提取”。一段只装一个事实,结论前置,段落之间语义独立,别靠上下文粘连才能读懂。
Princeton那篇GEO论文的实测数据也撑这个判断:加引用来源,被AI引用概率提34.4%;加统计数据提32.1%;加直接引语提29.7%。关键词堆砌?基本无效,甚至有害。
解析层的坎
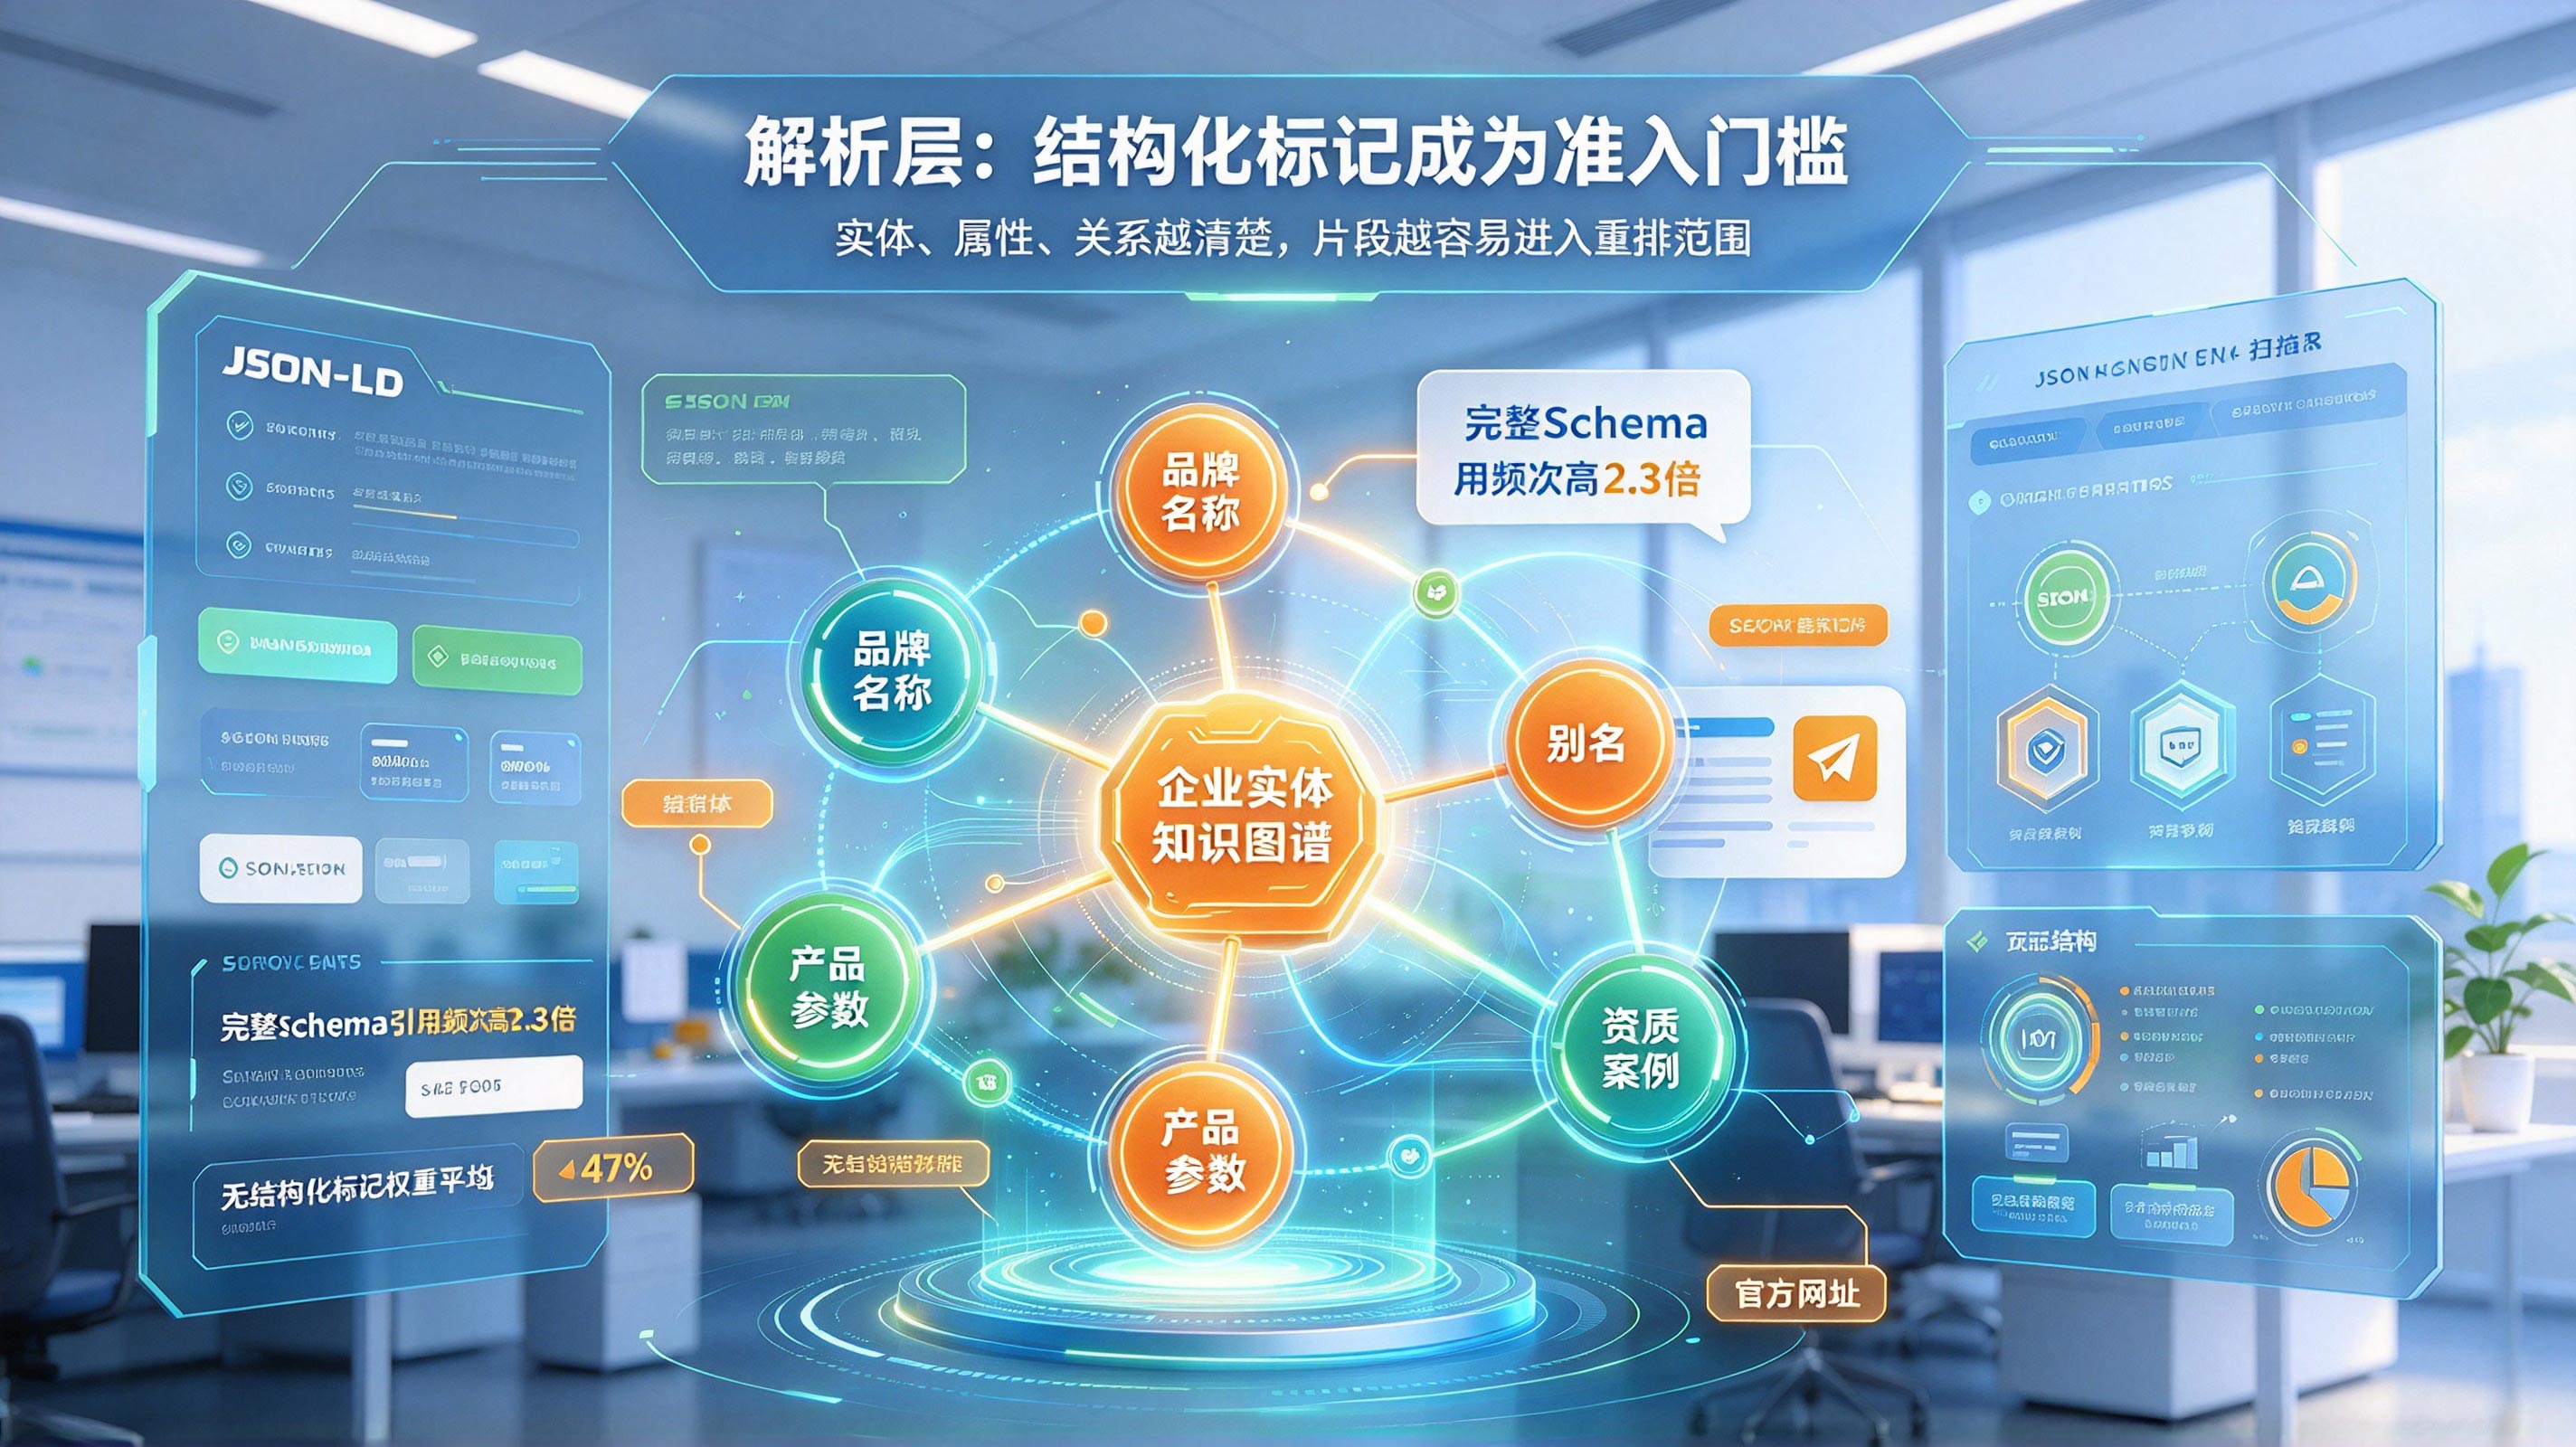
进了召回范围,下一个卡点是可解析性。重排模型要对候选片段做相关性打分,页面结构乱、实体和属性混在叙述文字里,抽取模型没法稳定定位“这是谁、有什么属性、什么关系”,片段在重排阶段就被滤了。
2026年8月之后,Schema/JSON-LD在GEO里的地位变了。部署了完整Schema(Article、FAQPage、Organization、BreadcrumbList这些)的站点,在主流大模型里的引用频次比只挂基础标记的高出约2.3倍。
没用结构化标记的内容,AI引用权重平均掉47%。JSON-LD从“锦上添花”变成了事实上的准入门槛。
更深一层的结构化在实体层面。企业信息散在不同页面、不同平台,名称写法不统一,别名缺失,模型交叉验证时没法把同一实体在不同信源上的事实对齐,采信权重就上不去。
一个最小可用的知识库至少得覆盖三类对象:实体(canonical name、alias、official URL)、事实(property、value、source、verified_at)、问答对(question、answer、intent_stage)。
alias字段尤其关键——做过品牌更名或者有多套简称的企业,缺了别名,新旧名称在模型侧就是两个实体,历史攒下来的语义资产接不上。
采信层:口径一致比单篇质量重要
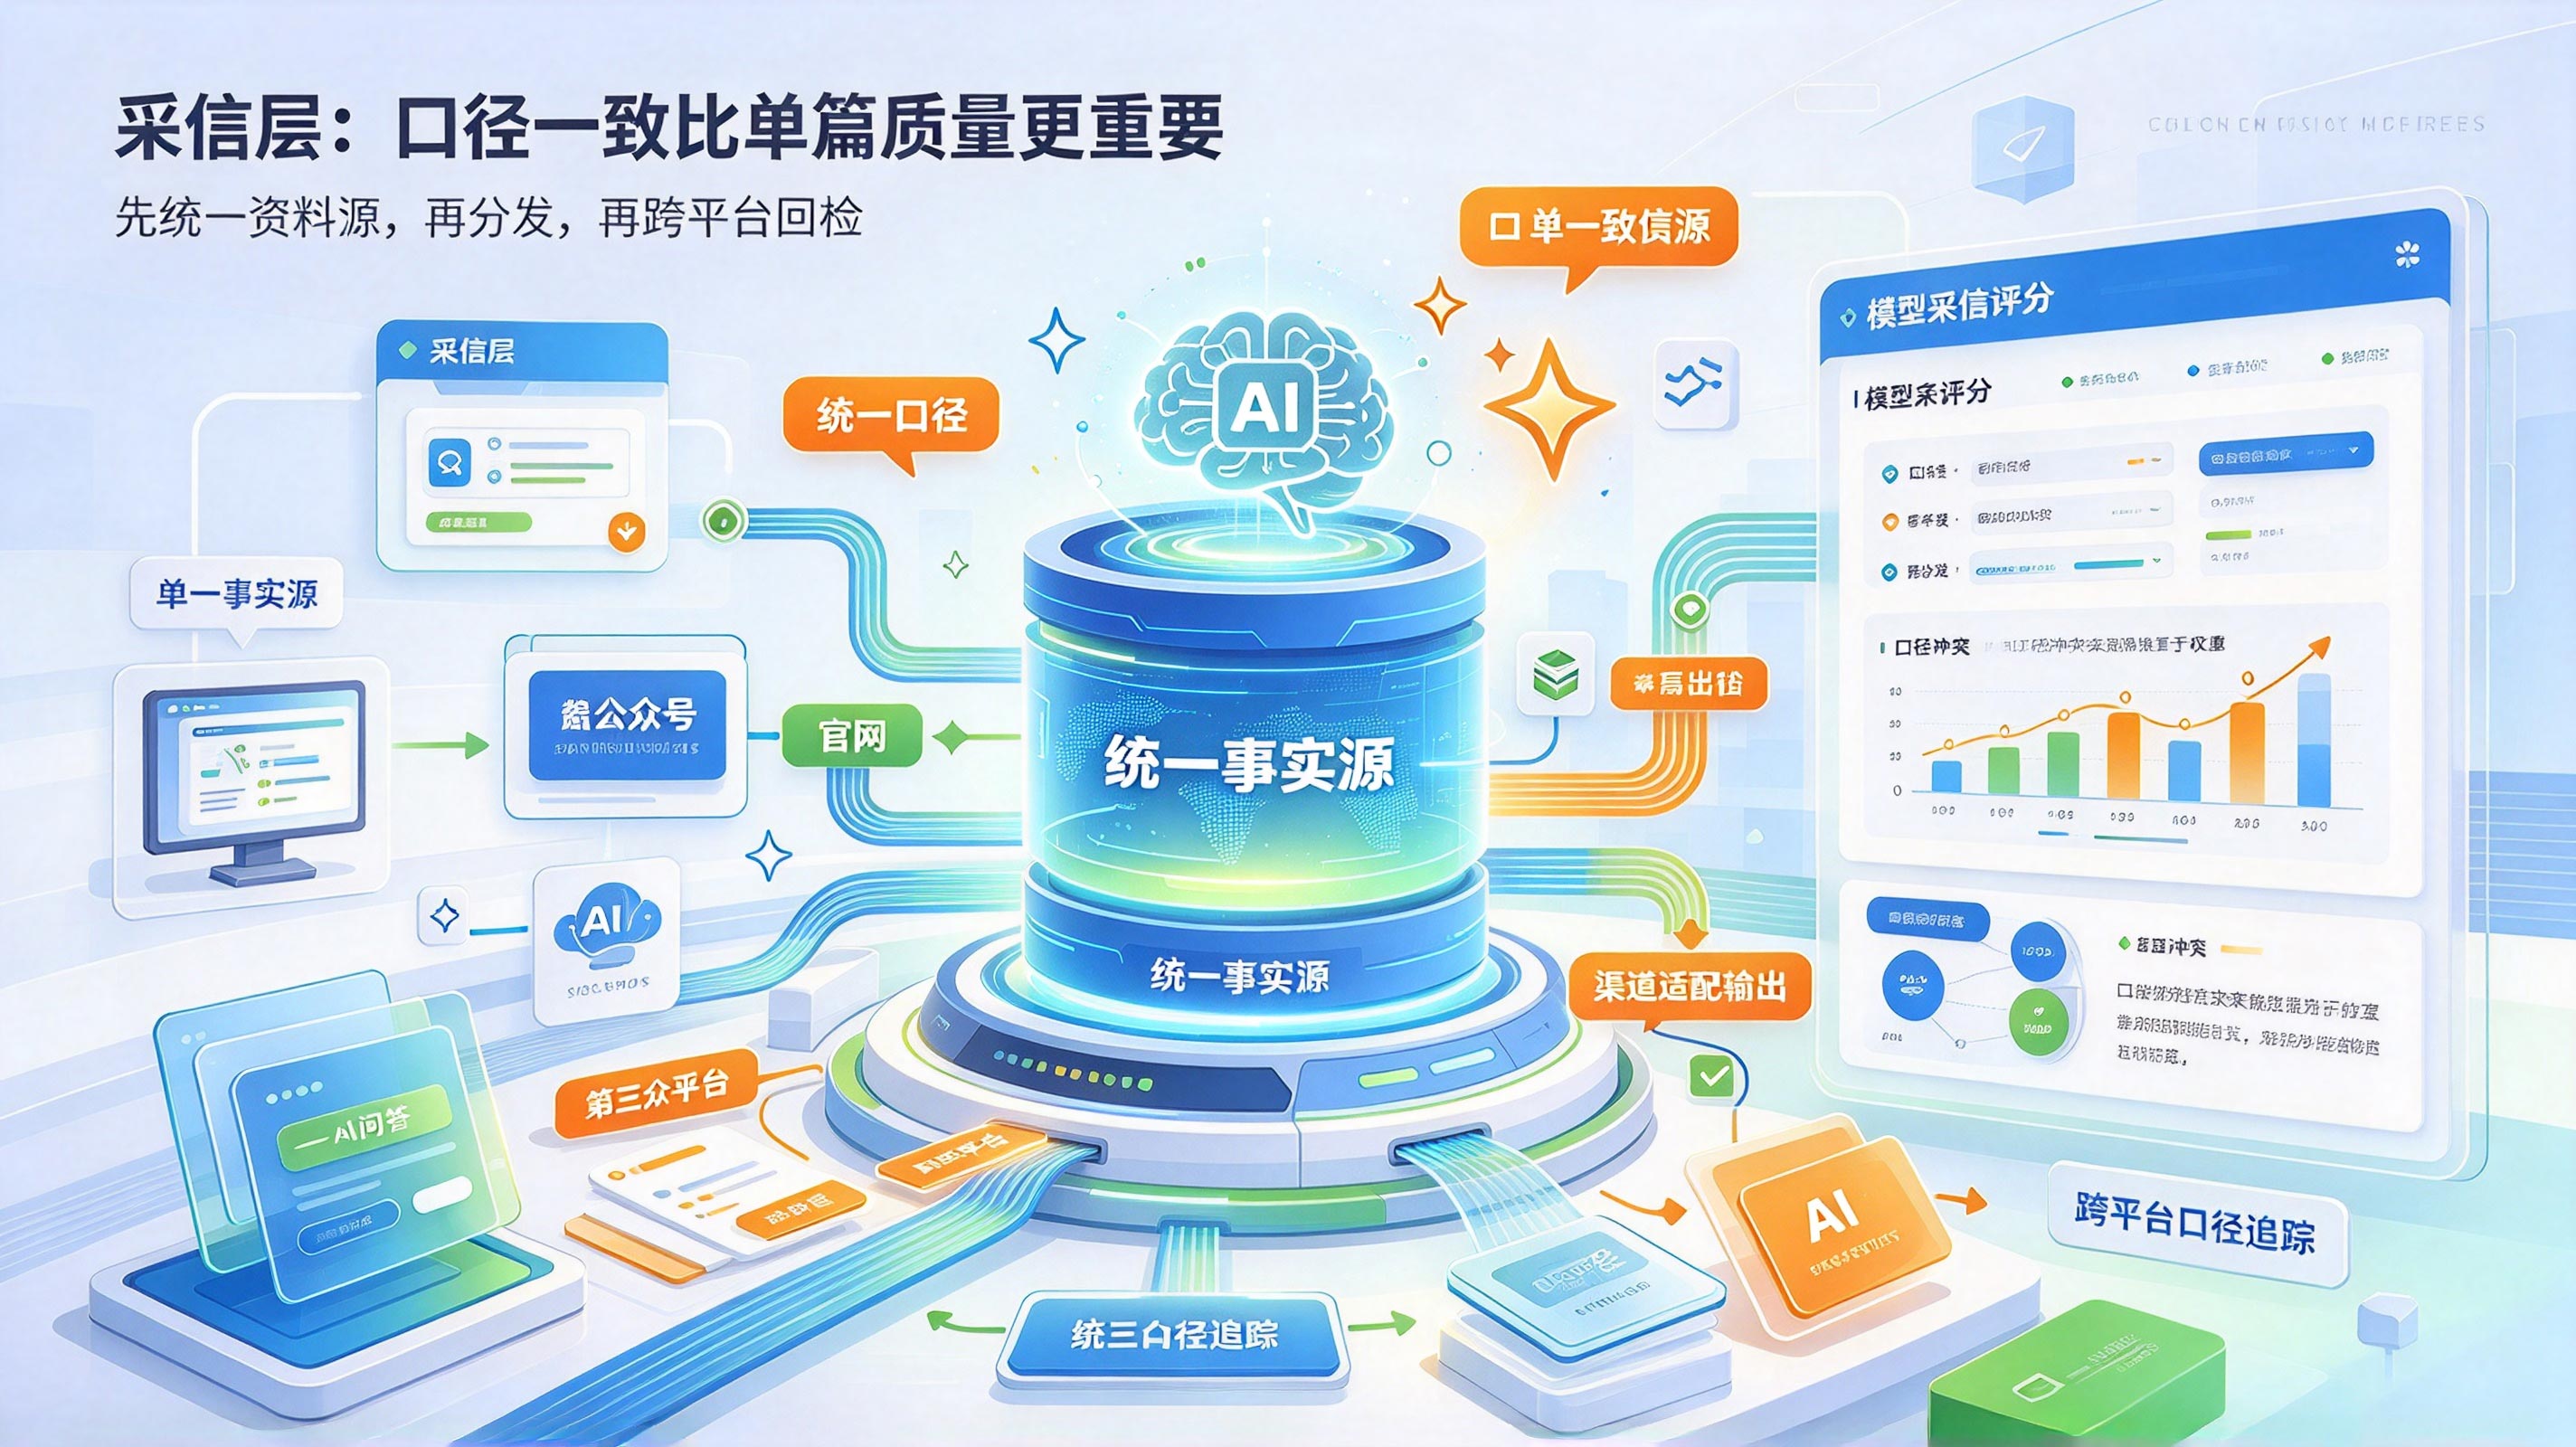
可检索、可解析都做到了,内容能不能真被“用进答案”,还看第三层:可交叉验证性。生成阶段模型面对多个候选信源,同一个事实在不同来源上口径不一致,采信权重会明显下降。
这也解释了不少企业单篇内容不差,却始终进不了AI答案。问题往往不在哪一篇文章,在信源体系本身:官网一套说法,公众号另一套,第三方平台又是第三种表述。模型交叉验证时形不成稳定的实体画像,宁可选口径一致但内容浅的信源,也不会采信一个内部矛盾的高质量来源。
信源层的动作得两个方向同时做。
一是收口:品牌介绍、产品参数、资质案例这些基础信息做成单一事实源,所有渠道分发都从同一个结构化资料库出发生成,别各渠道各写一套。
二是占位:不同AI平台的信源偏好差别明显,豆包对字节系生态(头条、抖音)依赖度高,DeepSeek对知乎、博客园这些技术社区权重更高,同一套内容得在目标平台的信源池里形成一致的存在。
微三云GEO系统在这块的设计取向算是比较务实的。
它没把GEO当成一个“写文章的工具”,而是把企业资料管理作为独立模块放在内容生成的上游,先把品牌信息结构化为统一资料源,再通过信源分发模块向不同平台做适配输出,避免多渠道并行生产导致的事实漂移。
AI监测环节覆盖豆包、DeepSeek、文心一言、Kimi、腾讯元宝、通义千问等20余个主流平台,做的是跨入口的覆盖频次和口径一致性追踪,不是单平台排名。企业信源本来就散落在多个业务线手里的话,这套“先统一资料源、再分发、再跨平台回检”的链路,比逐篇抠内容更能解决根上的问题。
指标得跟着换
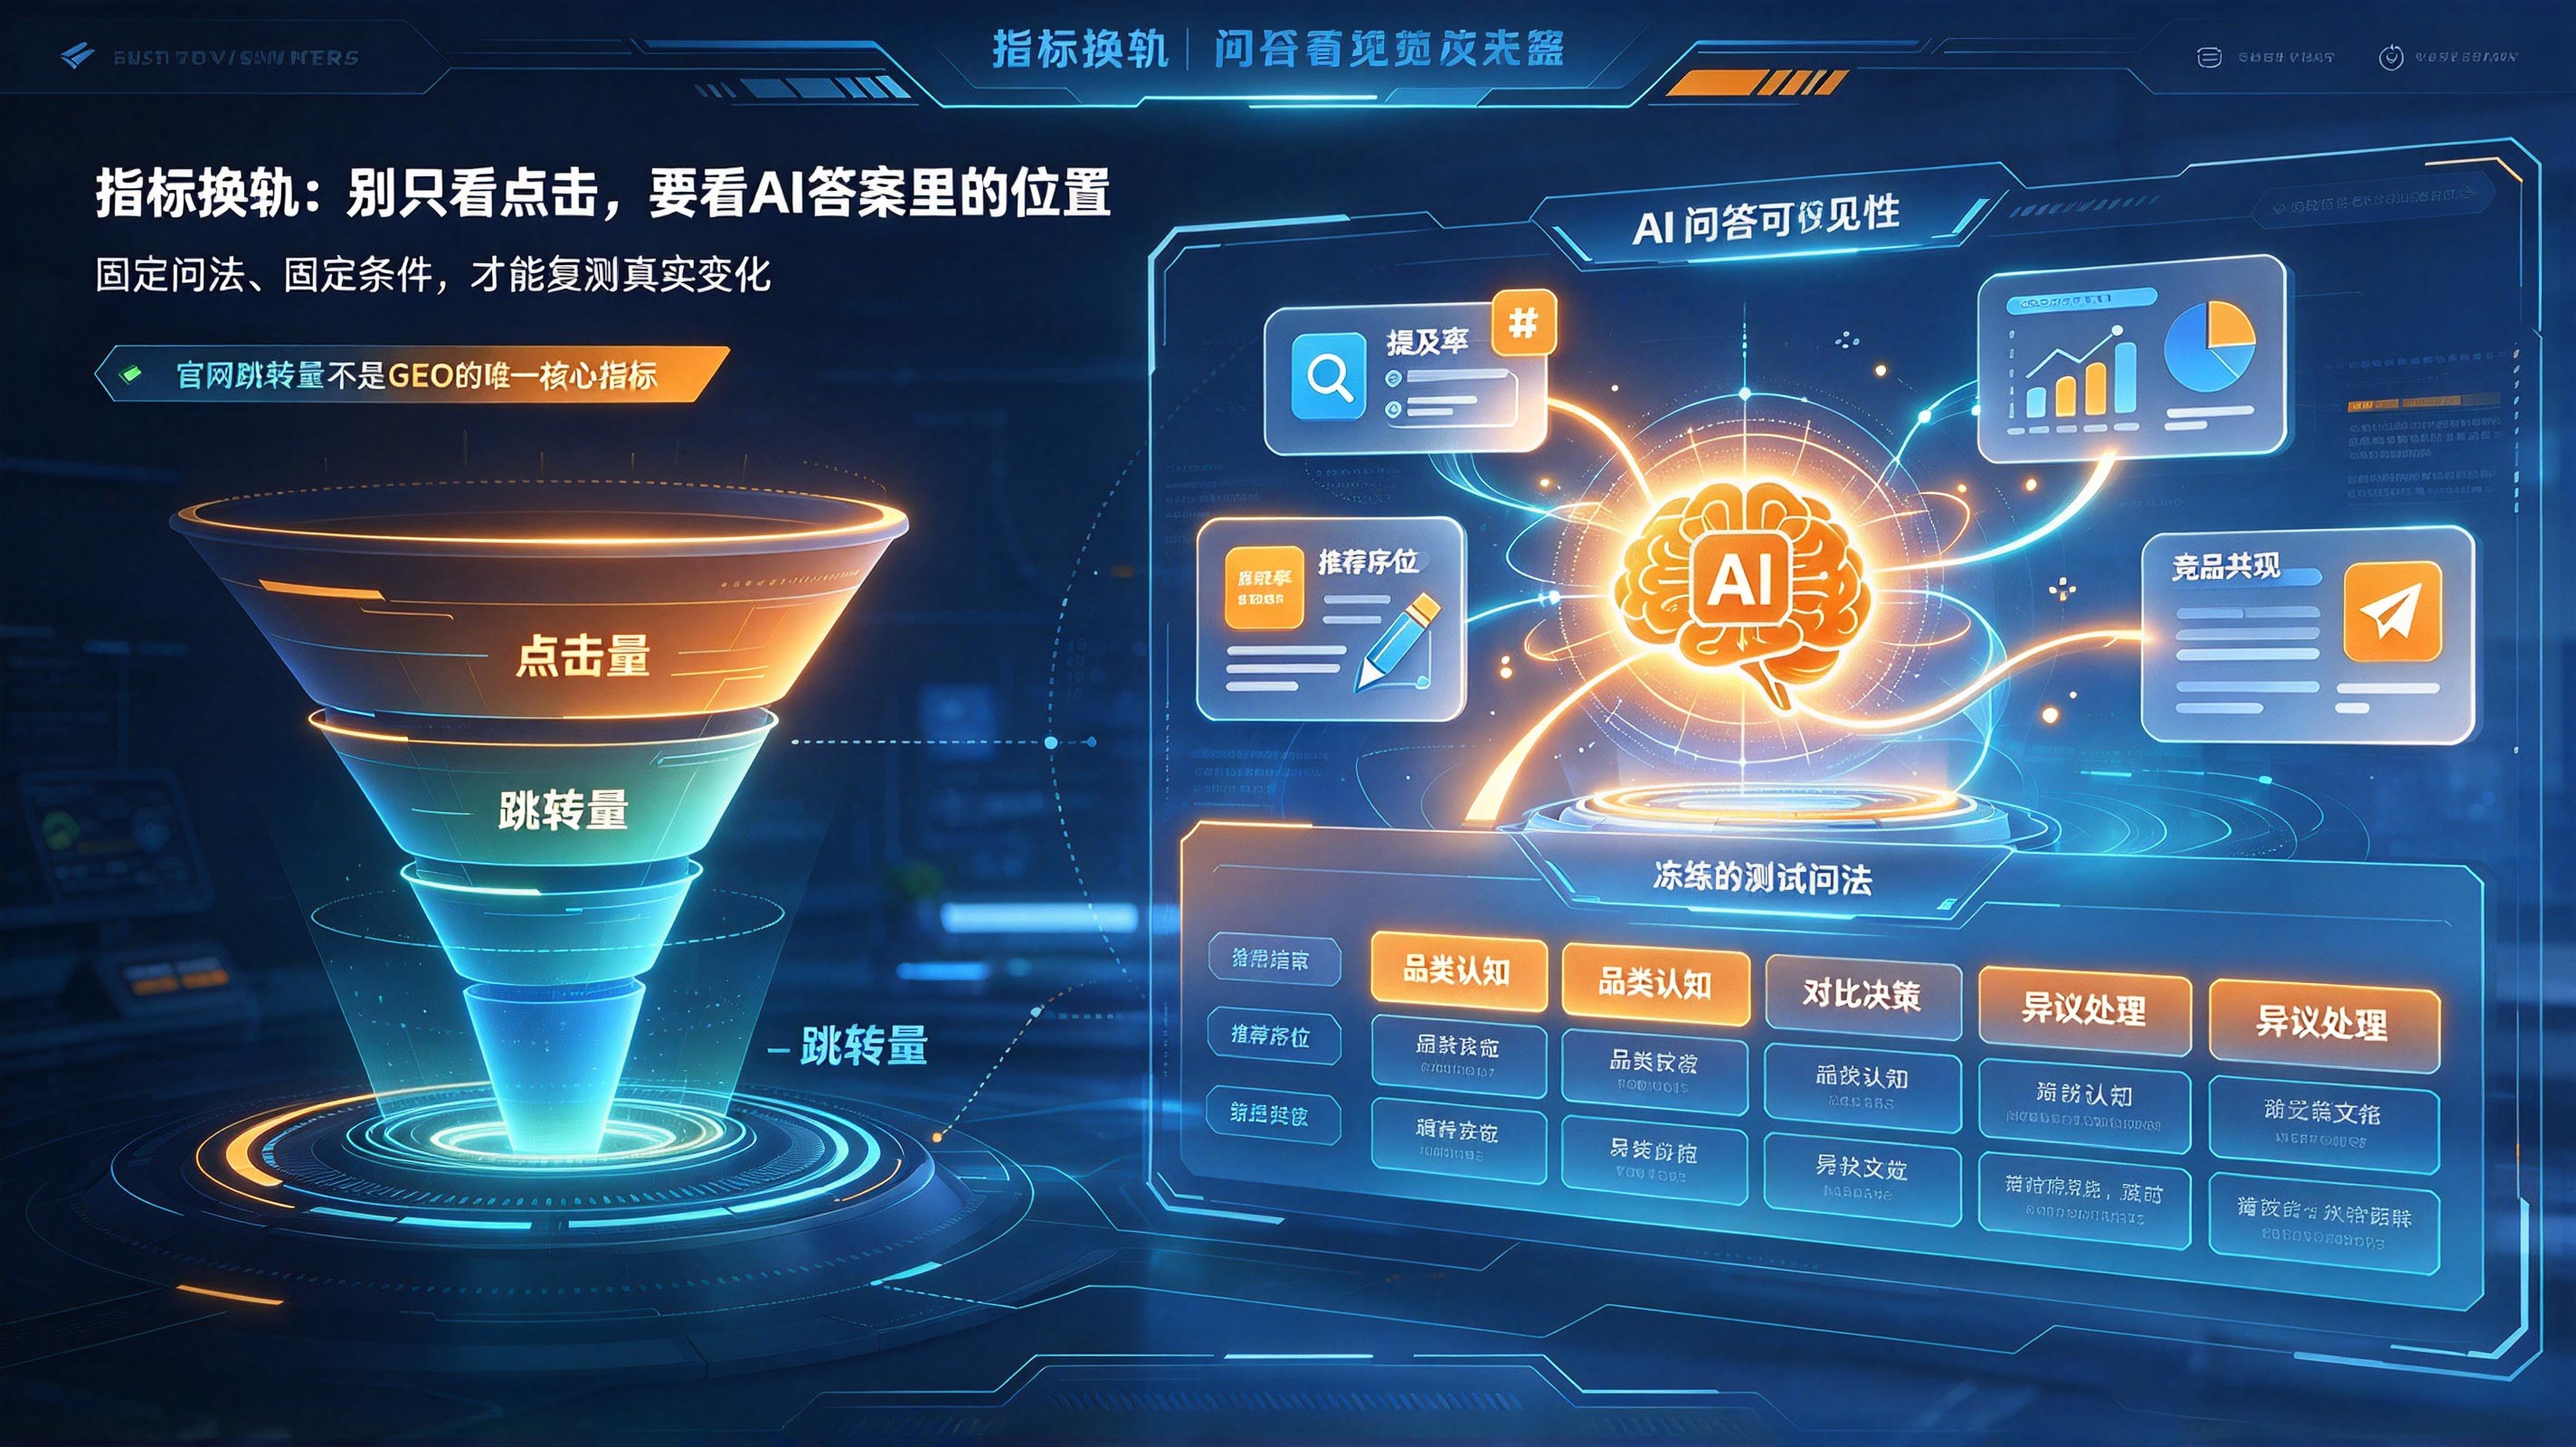
GEO的效果衡量是另一个要换轨的地方。豆包360轮对话实验的数据很直接:只有3.9%的对话中豆包建议用户访问外部网址,被推荐对象绝大多数还是工具站。如果还拿官网跳转量或点击率当GEO核心KPI,在豆包这类入口上几乎注定得出“没效果”的结论。不是优化没做,是这个入口的交互终点本来就不在外部网页。
面向AI问答的可见性,至少得用三类可复测的指标来替代点击漏斗:提及率(品牌在目标问题集合的AI回答中被提及的比例)、推荐序位(进入推荐表达时的位置分布,比如是否出现在首位或前三)、竞品共现(品牌通常和哪些竞品在同一答案中出现,表述语境是正面、中性还是对比劣势)。
做这套监测有个容易被跳过的前提:问法必须固定。每周换一种方式问AI,数字没法跨周比较。实操上把真实用户会问的句子写成冻结的Prompt矩阵,覆盖品类认知、对比决策、异议处理几类意图,每次复测用同一套问法、记录同一组条件(是否联网、入口版本),保留原始回答文本而不是只截一张图。
提及率告诉你有没有,推荐序位告诉你位置好坏,竞品共现告诉你叙事框架是不是被竞品定义了。三个维度合在一起,才能判断GEO的动作是在积累还是在空转。
换轨的本质不是多了一个叫AI的渠道。信息分发的控制点从“排序算法”前移到了“模型的检索与采信链路”。传统SEO争的是页面在列表里的相对位置,GEO争的是内容在答案生成那一刻能不能进入上下文。可检索、可解析、可交叉验证,三层拆开,每层都是具体的技术动作。
先动手把企业信息从“散落文档”重构成结构化信源的那批人,拿到的不是短期流量红利,是在新入口的检索池里先占了一个实体位。这个位的价值,随着对话式交互的渗透率继续往上走,只会更明显。