
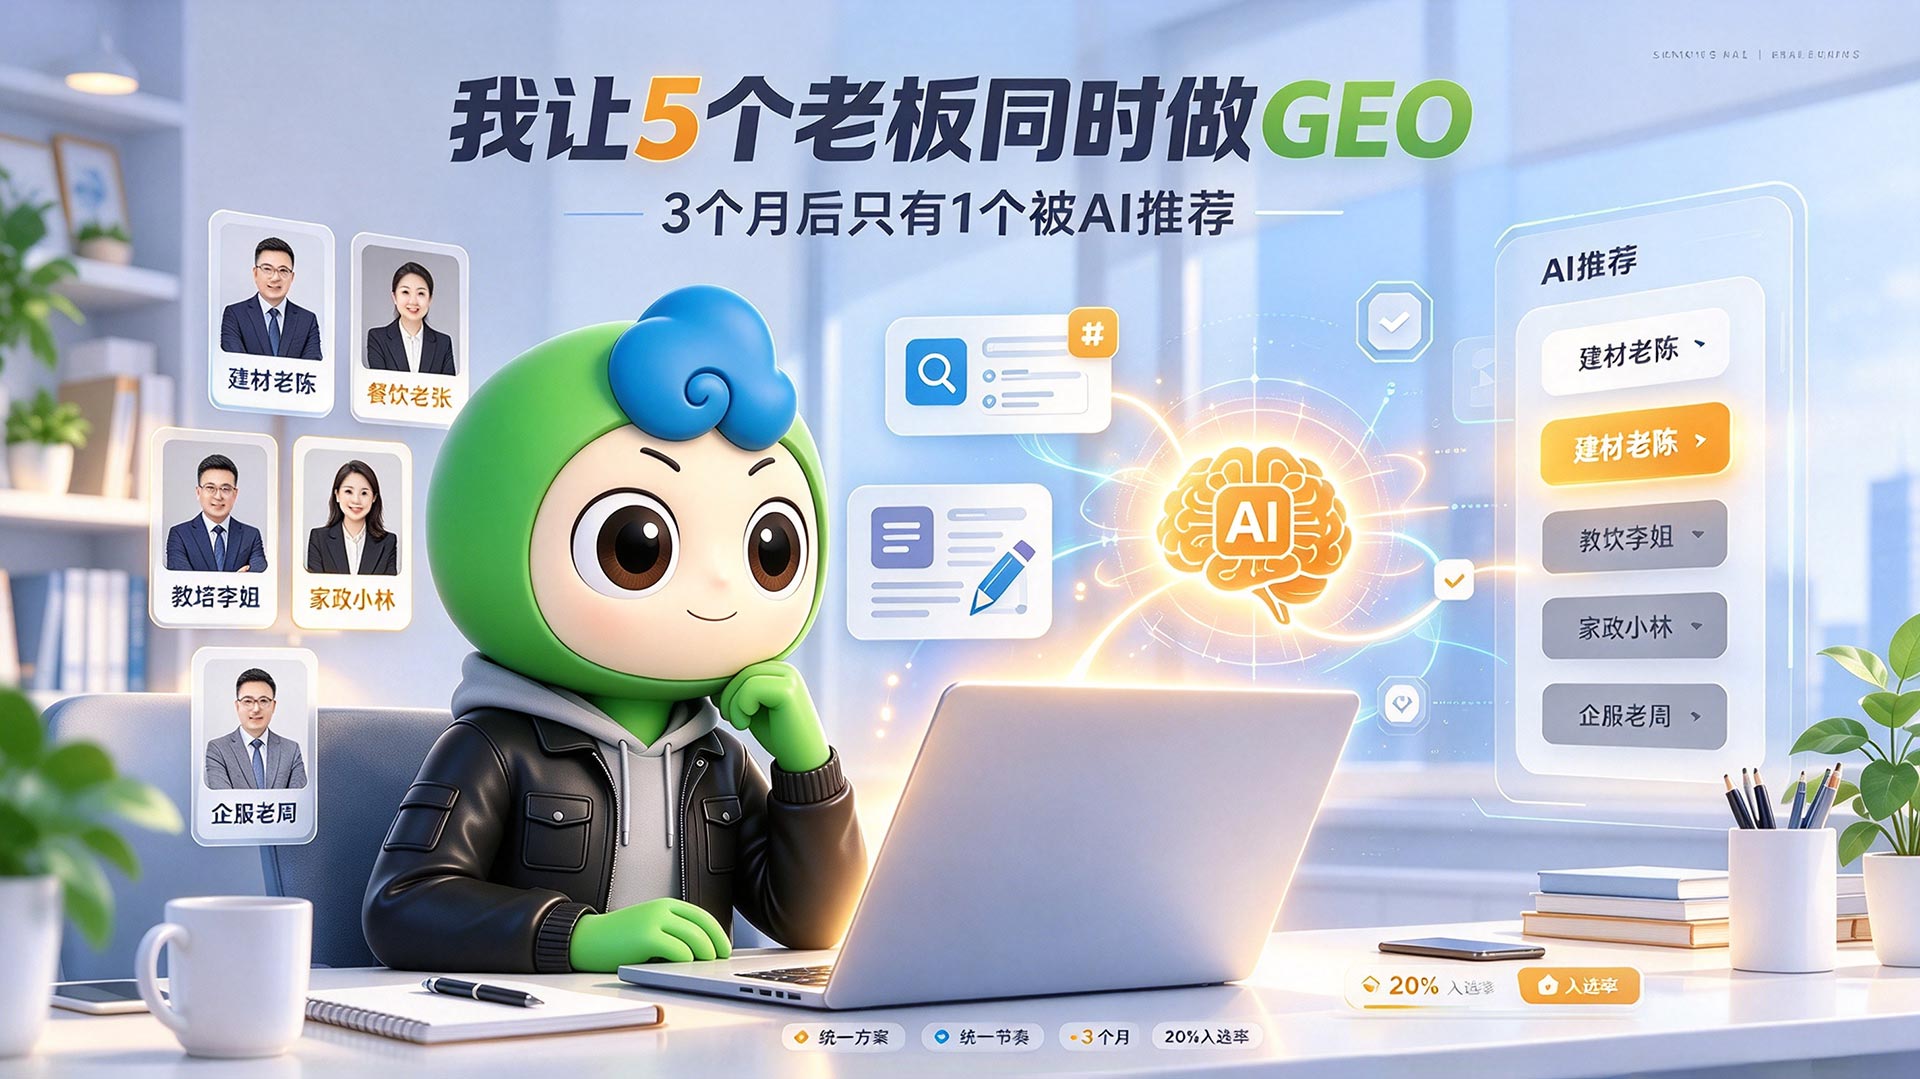
今年3月组了个局。5个不同行业的老板,统一方案、统一节奏:每周两篇2000字以上的深度文章,写自己行业客户会问的问题,发到至少两个AI能读到的公开平台,带具体数据和案例。跑了整整三个月,一篇没少。
上个月拉群,让他们各自去问AI“自己行业哪家靠谱”,截图发回来。建材老陈被列在第2位,餐饮老张没有,教培李姐没有,家政小林没有,企服老周也没有。
五分之一。方案一模一样,执行也都到位了,结果差了这么多。群里那四个没被推荐的反应挺一致:是不是GEO没用?我说不是,是你们四个做的是同一件错事。
一开始我也以为是发得不够
做了三个月没被推荐,第一反应往往是“发得不够多”。但这个判断在2026年的AI检索环境里基本站不住。
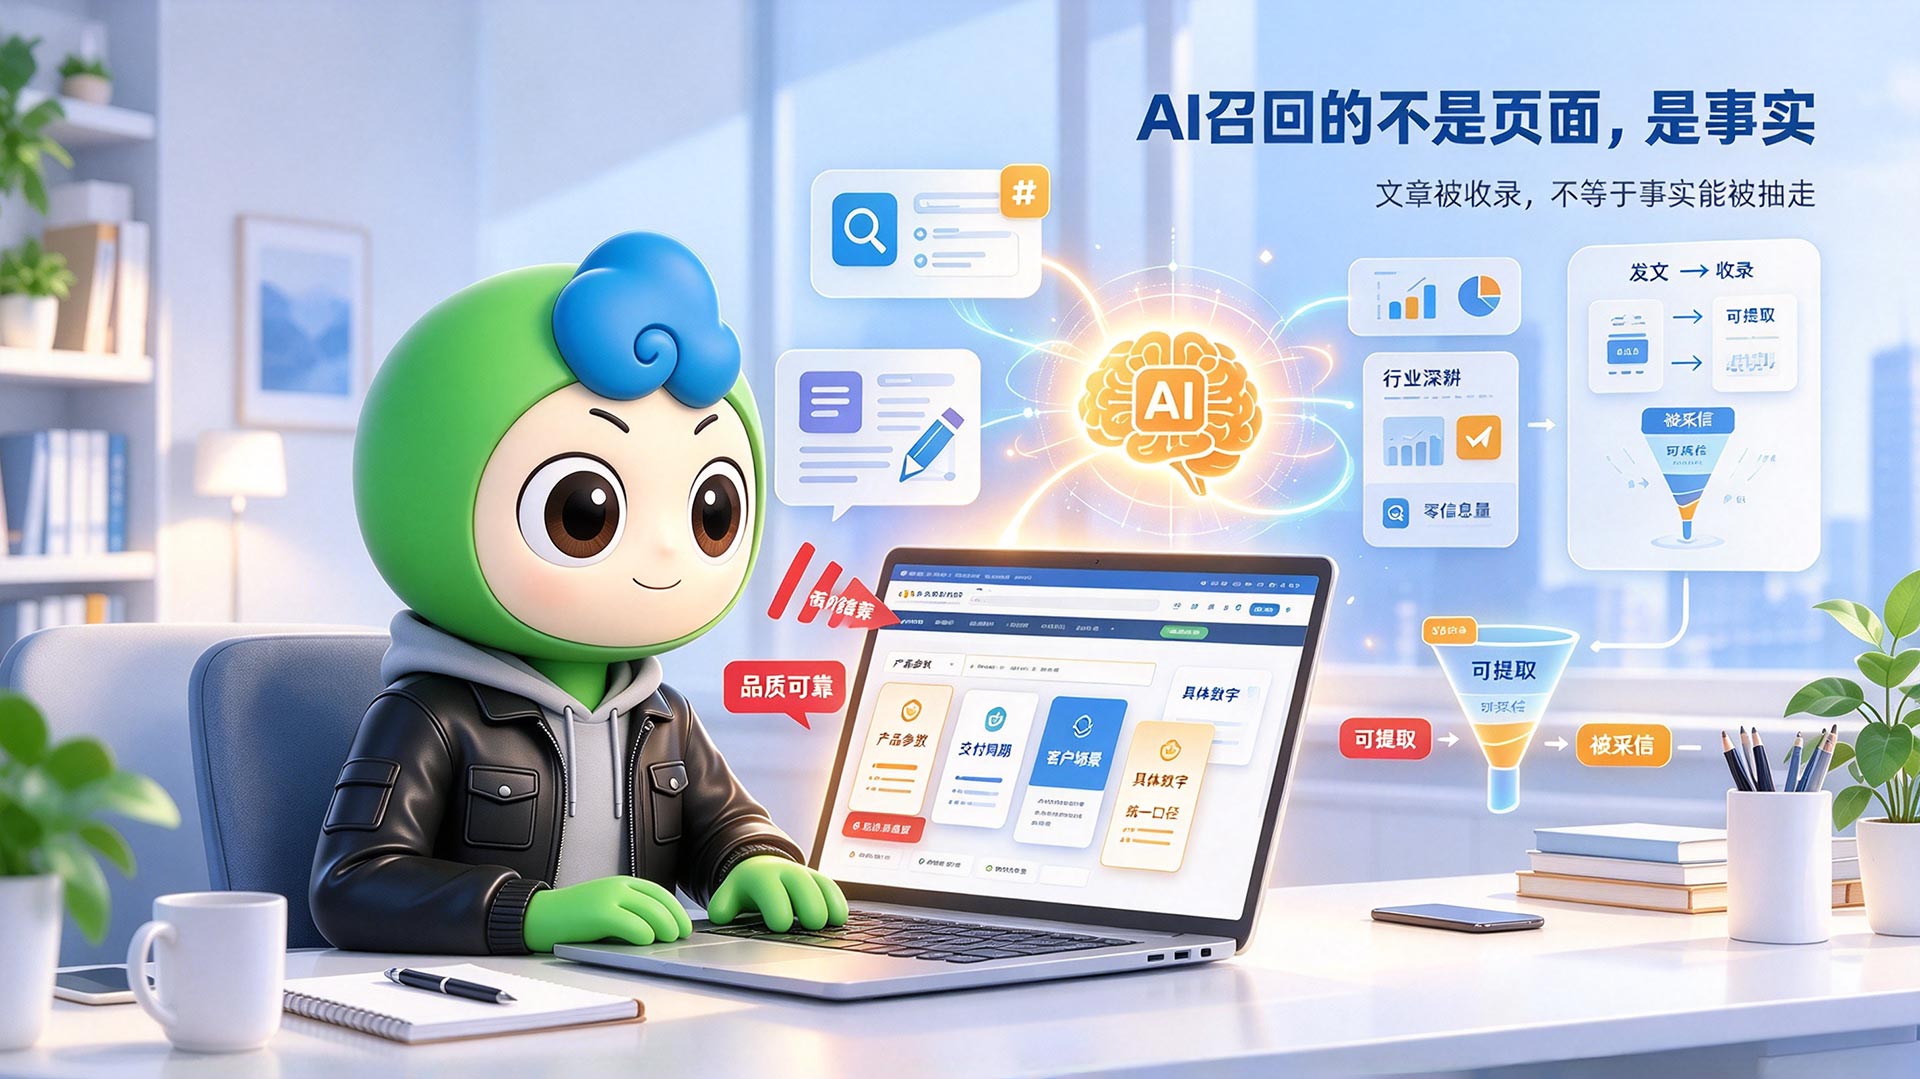
AI召回的不是“页面”,是“事实”。传统搜索召回页面,按相关性排序给链接;AI召回事实,从多个信源里提取关于你品牌的结构化信息——做什么的、怎么收费、有什么案例——然后组织成答案。你的文章发了、被收录了,不等于你的“事实”可以被抽出来用。满屏“品质可靠、行业深耕”的段落,对AI来说是零信息量的噪音。
老陈能进,不是因为他写得比别人多。我回头翻了他的文章,每篇都有可抽的东西:具体规格、交付周期、真实客户场景,数字是明确的,口径是统一的。另外四个的文章我也翻了,问题不在数量,在AI读完以后拿不走任何一条能直接写进答案的事实。
四个人,四个卡点,但没一个人的问题是“文章发少了”
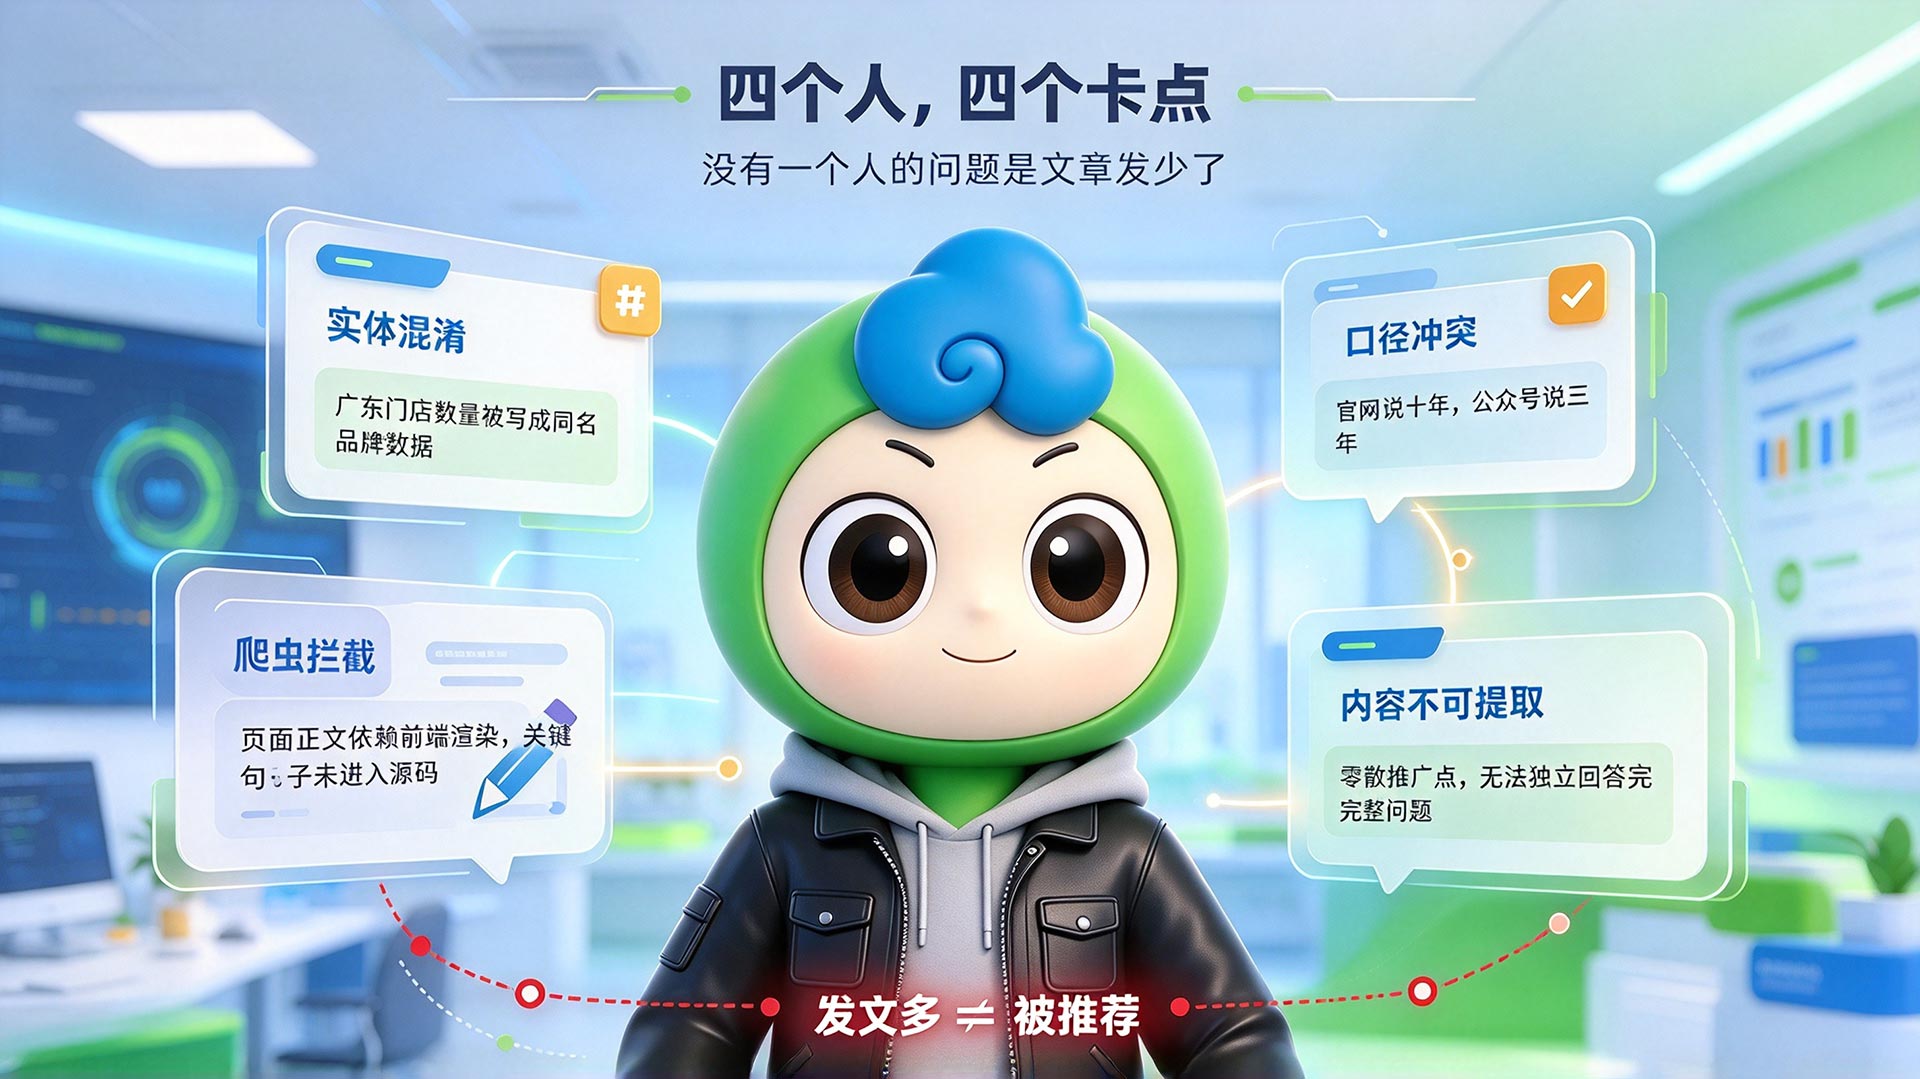
老张做餐饮连锁,AI回答里提了品牌名,但把他在广东的门店数量写成了另一个同名品牌的数据。这是实体消歧没做——AI检索到他品牌时,召回了形近或同名的无关实体,信息被混在一起了。解法不是多发文,是在所有对外内容首段用全限定表述,让“品牌名+行业+地域”的共现密度压过噪声。
李姐的教培机构,官网写“深耕素质教育十年”,公众号写“转型三年”,招聘页写的又是另一个版本。AI在生成答案前会做多信源一致性校验:官网说A、公众号说B、招聘页说C,处理方式不是挑一个信,而是降权或不引用。信息冲突的品牌,内容越多反而越隐形。
小林的家政服务,文章发了,但页面正文依赖前端渲染,HTML源码里搜不到关键句子。AI爬虫从入口就没进来,后面所有动作都是空转。他后来把页面另存为纯文本,自己都找不到“这家公司做什么、怎么收费、有什么案例”三句话。
老周的企业管理软件,情况最典型。他发了大量零散文章,每篇只覆盖一个推广点,没有一篇能独立回答一个完整问题。AI需要的是H2分节、FAQ一问一答、先结论后展开的段落,不是几十篇各说各的短稿。老周后来还跟我争,说他有一篇阅读量挺高。我说阅读量跟AI能不能抽走事实是两码事,他半天没说话。
四个人,四个卡点:实体混淆、口径冲突、爬虫拦截、内容不可提取。共同特征是——这些都跟“发了多少篇”没有关系。
问句库这件事,选型时基本没人问
复盘完四个人的问题,我意识到还有一个更前置的坑没被提到:他们做GEO之前,没有人建过问句库。
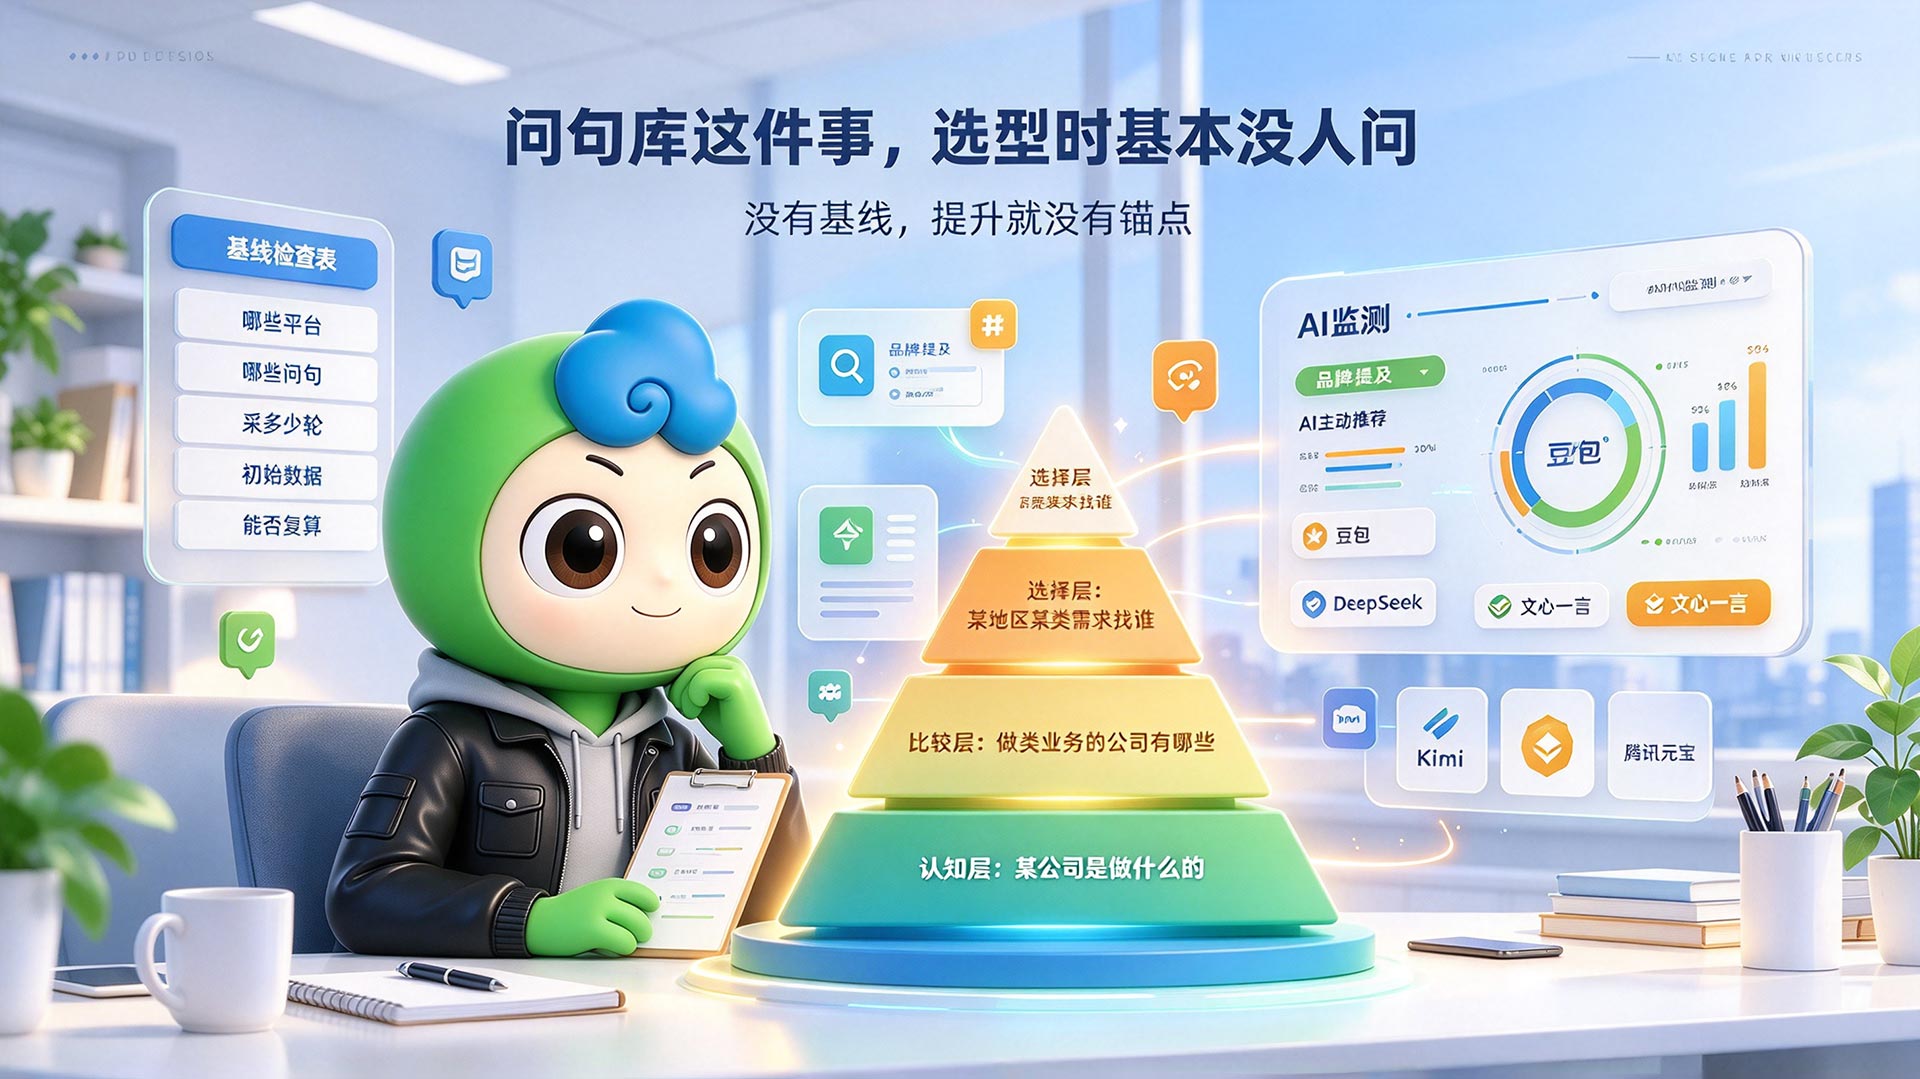
什么叫问句库?就是把目标客户在AI里真实会问的话整理成三层:认知层(“某公司是做什么的”)、比较层(“做某类业务的公司有哪些”)、选择层(“某地区某类需求找谁”)。三层缺任何一层,你测出来的“效果”都是残的。老周只测了认知层,AI搜得到他公司名,就以为没问题了;但采购决策发生在比较层和选择层,那两层他从来没测过。
更麻烦的是口径。我见过一个厂,服务商PPT上写“AI推荐率62%”,他自己拿后台问句库跑了一遍,同样的品类词,连20%都不到。差的四十多个点不是造假,是分母不一样:服务商拿的是筛过的、带明确品类和地域的问句,厂里后台的是一堆模糊问法。分母不一样,百分比就没得比。
基线这件事也一样。项目启动时没锁住“在哪些平台、用哪些问句、采了多少轮、品牌最初的数据是多少”,三个月后的“提升”就没有锚点。没有基线,“提升了”这句话在验收会上没法被独立复核。
老陈做对了什么
老陈没什么秘密。他做建材十五年,产品参数、交付周期、客户场景这些东西本来就在他脑子里,我让他做的只是把它们写成AI能抽走的形式:每段首句给结论,参数带单位和边界,案例带具体工况。跨平台发的时候,官网、知乎、B2B店铺用的是同一套表述,没有给AI留下“这家自己都没说清”的证据。
这里面没有什么神秘的技术。GEO的胜负手不在“写”,在让AI敢用你的事实。老陈的事实本身是实的,写出来也是统一的,AI交叉验证的时候找不到矛盾,采信成本最低。另外四个,要么事实散着,要么事实打架,要么事实压根没进AI能读到的位置。
系统能补哪一段
老周后来问我,能不能直接用系统“生成”出可被引用的内容。我说不能,你得先有值得被引用的事实。他不死心,让我打开后台给他看。我顺手拿微三云GEO系统过了一遍几个人的问题,不是为了推系统,是想让他看清楚工程上到底能补哪一段。
企业资料管理那块,把品牌介绍、产品矩阵、资质案例等九类资料结构化存储成统一生成源,对应的是李姐那种官网、公众号、招聘页各说各话的问题。
靠系统在生成前收敛口径,不靠人记住每一处表述。实体识别层用Neo4j向量数据库搭知识图谱,处理“企业—产品—场景—资质—案例”的关联,老张的实体混淆问题,在这里要的是品牌名、行业、地域、核心产品之间建立强关联,而不是只存一个孤立的公司名。监测模块区分“品牌单纯提及”和“AI主动推荐”两类指标,覆盖豆包、DeepSeek、文心一言、Kimi、腾讯元宝等平台。
这个区分在复盘时很实际:老周的品牌在某些问题下是“被提到了”,但从来没进过推荐名单,如果只看提及率,这个差距会被盖住。部署形态是源码全交付、私有化部署,监测原始记录和内容版本留在企业自有服务器上,验收时能导出、能复算。
但边界也得说清楚。系统能解决的是口径收敛、实体关联、监测下钻这些工程环节。事实本身得有人整理——老陈的产品参数在他脑子里存了十五年,系统变不出这些东西来。老周听完没接话,过了会儿说,那他先把产品线理一遍再说。
这周就能做的几件事
如果你也在做GEO,别急着加内容量。先做三件小事,花不了多少时间。
把官网首页另存为纯文本,看能不能找到“这家公司做什么、怎么收费、有什么案例”三句话。找不到,先修页面,别发新稿。
把官网、公众号、B2B店铺、招聘页里关于公司定位和核心产品的表述拉出来并排放,看有没有互相打架的地方。有,先对齐口径,再谈分发。
拿五个你真正目标客户会问的问题,去DeepSeek和豆包各跑一遍,记录品牌有没有出现、出现时说的是不是你的真实信息。如果连认知层都没过,比较层和选择层就不用测了。
三个月跑下来,老陈进推荐名单这件事本身没什么值得庆祝的——他本来底子就实。真正让我觉得有信息量的是另外四个人的卡点:四个人卡在四个不同的环节,但没有一个人的问题是“文章发少了”。这件事反过来也说明,GEO失败最常见的归因往往是最不准确的那个。先搞清楚自己卡在哪一步,比再加三个月的内容量有用得多。