
做铝方通的老周,去年底在DeepSeek搜自己型号,回答里给的厚度是隔壁那家的。他拿着截图去问服务商,对方说内容发得不够多。又发了三个月稿,品牌名总算出来了,参数还是错的。
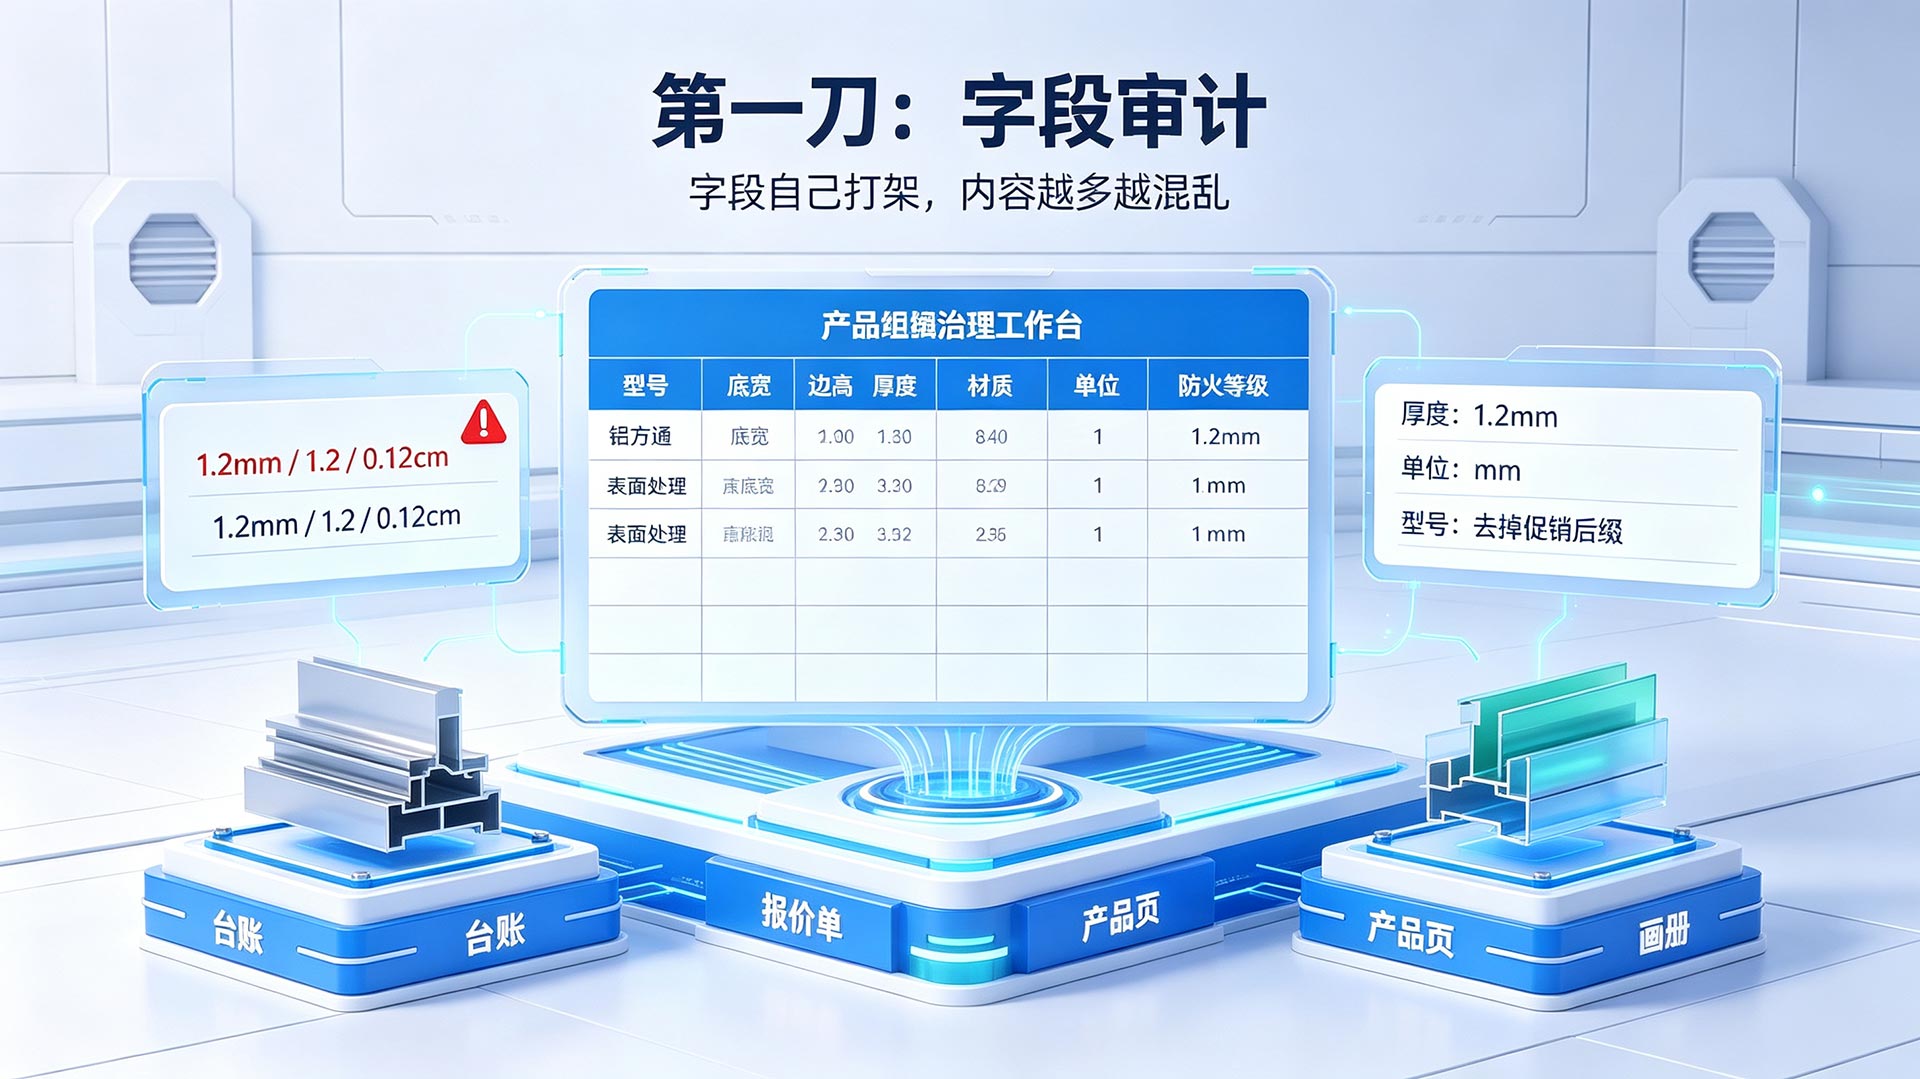
问题不在发稿量。他后来自己把产品页翻了一遍,发现同一个型号在官网写“厚度1.2mm”,B2B店铺写“1.2”,画册PDF里写“0.12cm”。三个地方三个写法。模型交叉验证时看到冲突,要么不写,要么随便挑一个写。AI不是不认识他,是不敢确认这参数到底归谁。
老周后来做的事,没有一件是“多发稿”。
先按住字段,再谈内容
建材这行有个麻烦:参数不是不够,是太散。铝方通的底宽、边高、厚度、表面处理、长度定尺,每个字段在台账、报价单、产品页、画册里各有一套写法。销售看得懂,模型读不懂。
他第一刀不是写新内容,是拉字段审计。SKU、spec_value、unit三个字段的取值分布先跑出来,异常值超过5%的排前面改。型号字段去掉促销后缀和批次后缀,材质颜色从共用的“规格”下拉框里拆出来,单位统一到mm,旧页面批量回刷。
这活听着像数据治理,不像GEO。但它是地基。字段自己打架,问句库建得再好、内容写得再结构化,模型拿到的还是互相矛盾的证据。
问句从关键词换成采购场景
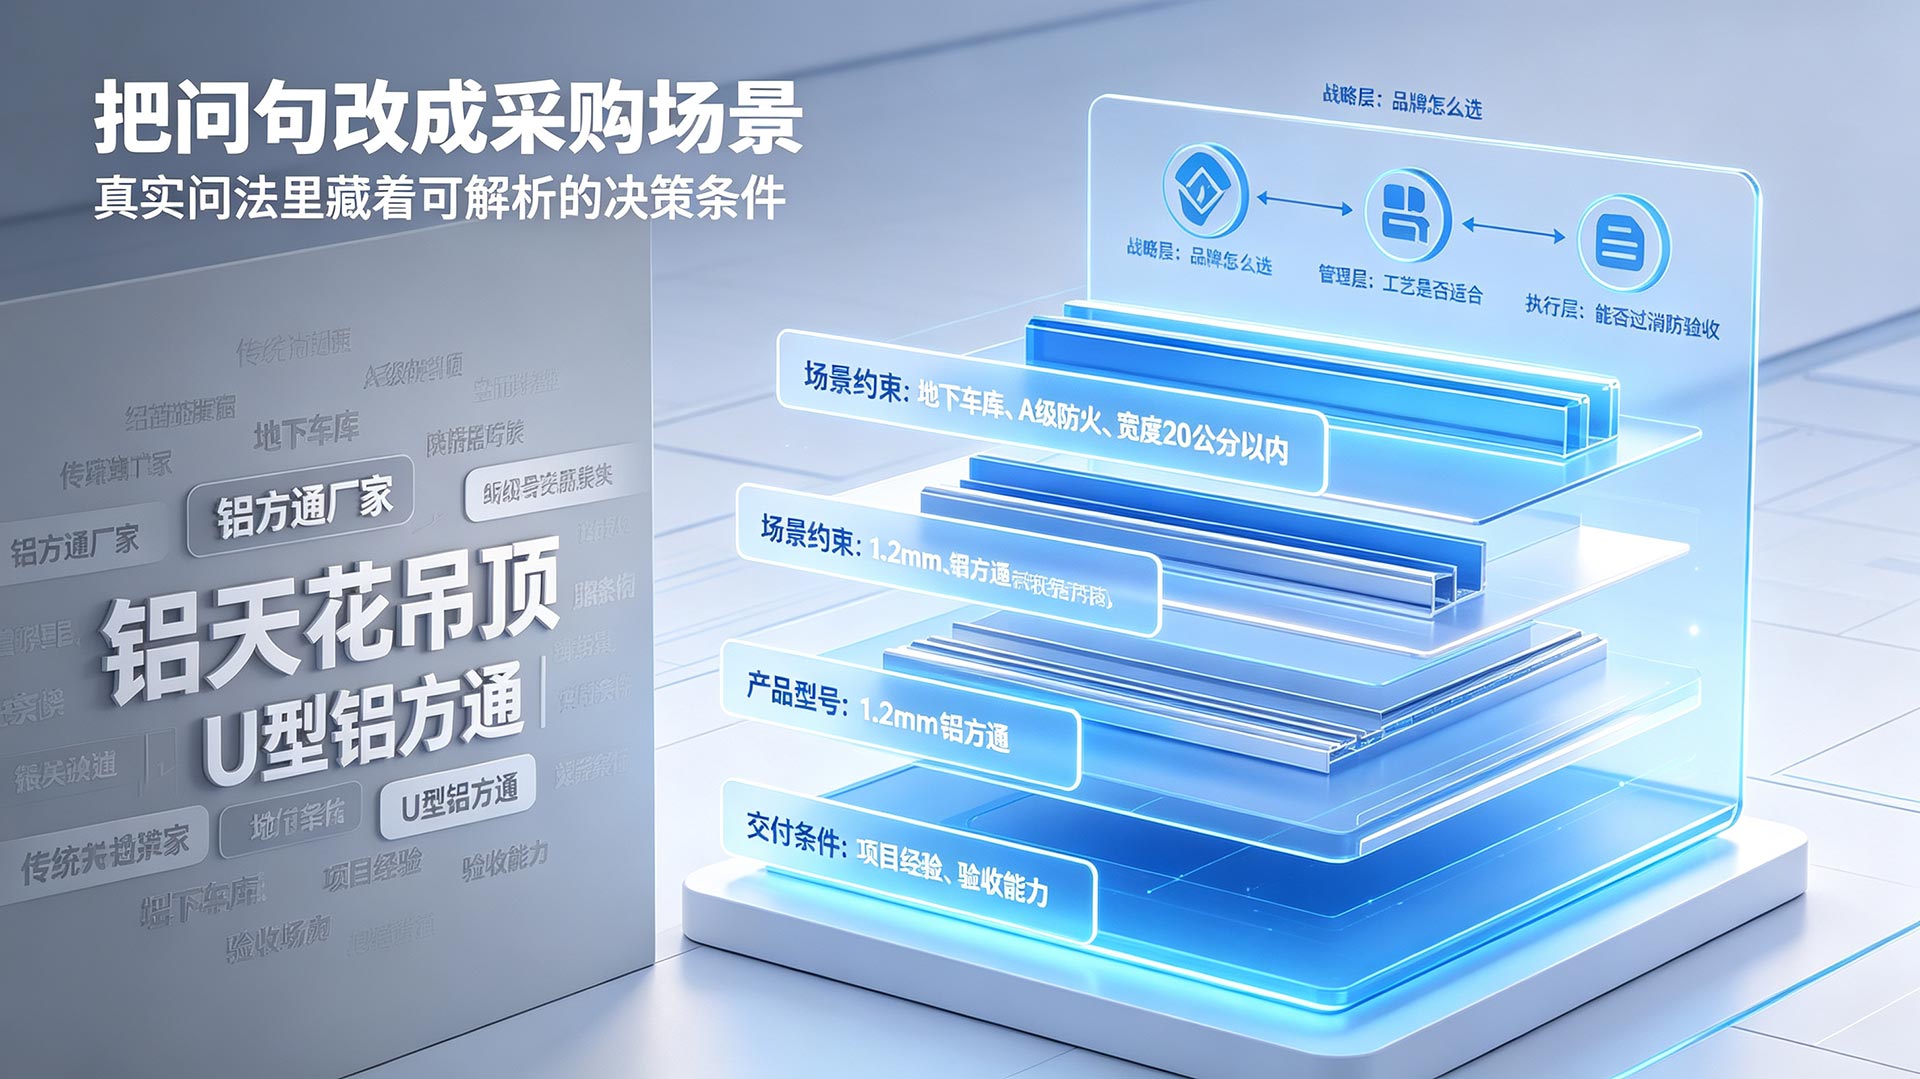
字段按住之后,老周开始改问句库。之前用的是一组大词:“铝方通厂家”“铝天花吊顶”“U型铝方通”。这些在传统搜索里有位置,但生成式引擎里没人这么问。
装修建材采购的真实问法带着很强的场景约束:空间类型、尺寸条件、安装环境、预算区间、同项目经验。一个工装采购在DeepSeek里问的是“地下车库吊顶用铝方通,防火等级要A级,宽度20公分以内,有没有做过类似项目的厂家”,不是“铝方通哪家好”。
前一种问法里有材质约束、消防要求、尺寸边界、项目经验四个可解析条件,后一种只触发品牌层比较,SKU级信息根本没机会出场。
他把问句库按“场景约束 × 产品型号 × 交付条件”三层重新组织,每个问句对应一个采购决策节点。建材采购链长,战略层问“品牌怎么选”,管理层问“哪种工艺适合地下车库”,执行层问“1.2mm厚的铝方通能不能过消防验收”。三层不拆开,内容生产没靶子。
同一件事实在多个信源层级上出现
第三个动作最容易被误解成多平台分发。老周一开始也这么理解:知乎发一遍、小红书发一遍、行业网站发一遍。后来发现同一篇稿子换三个平台发,模型眼里还是一个信源孤证。
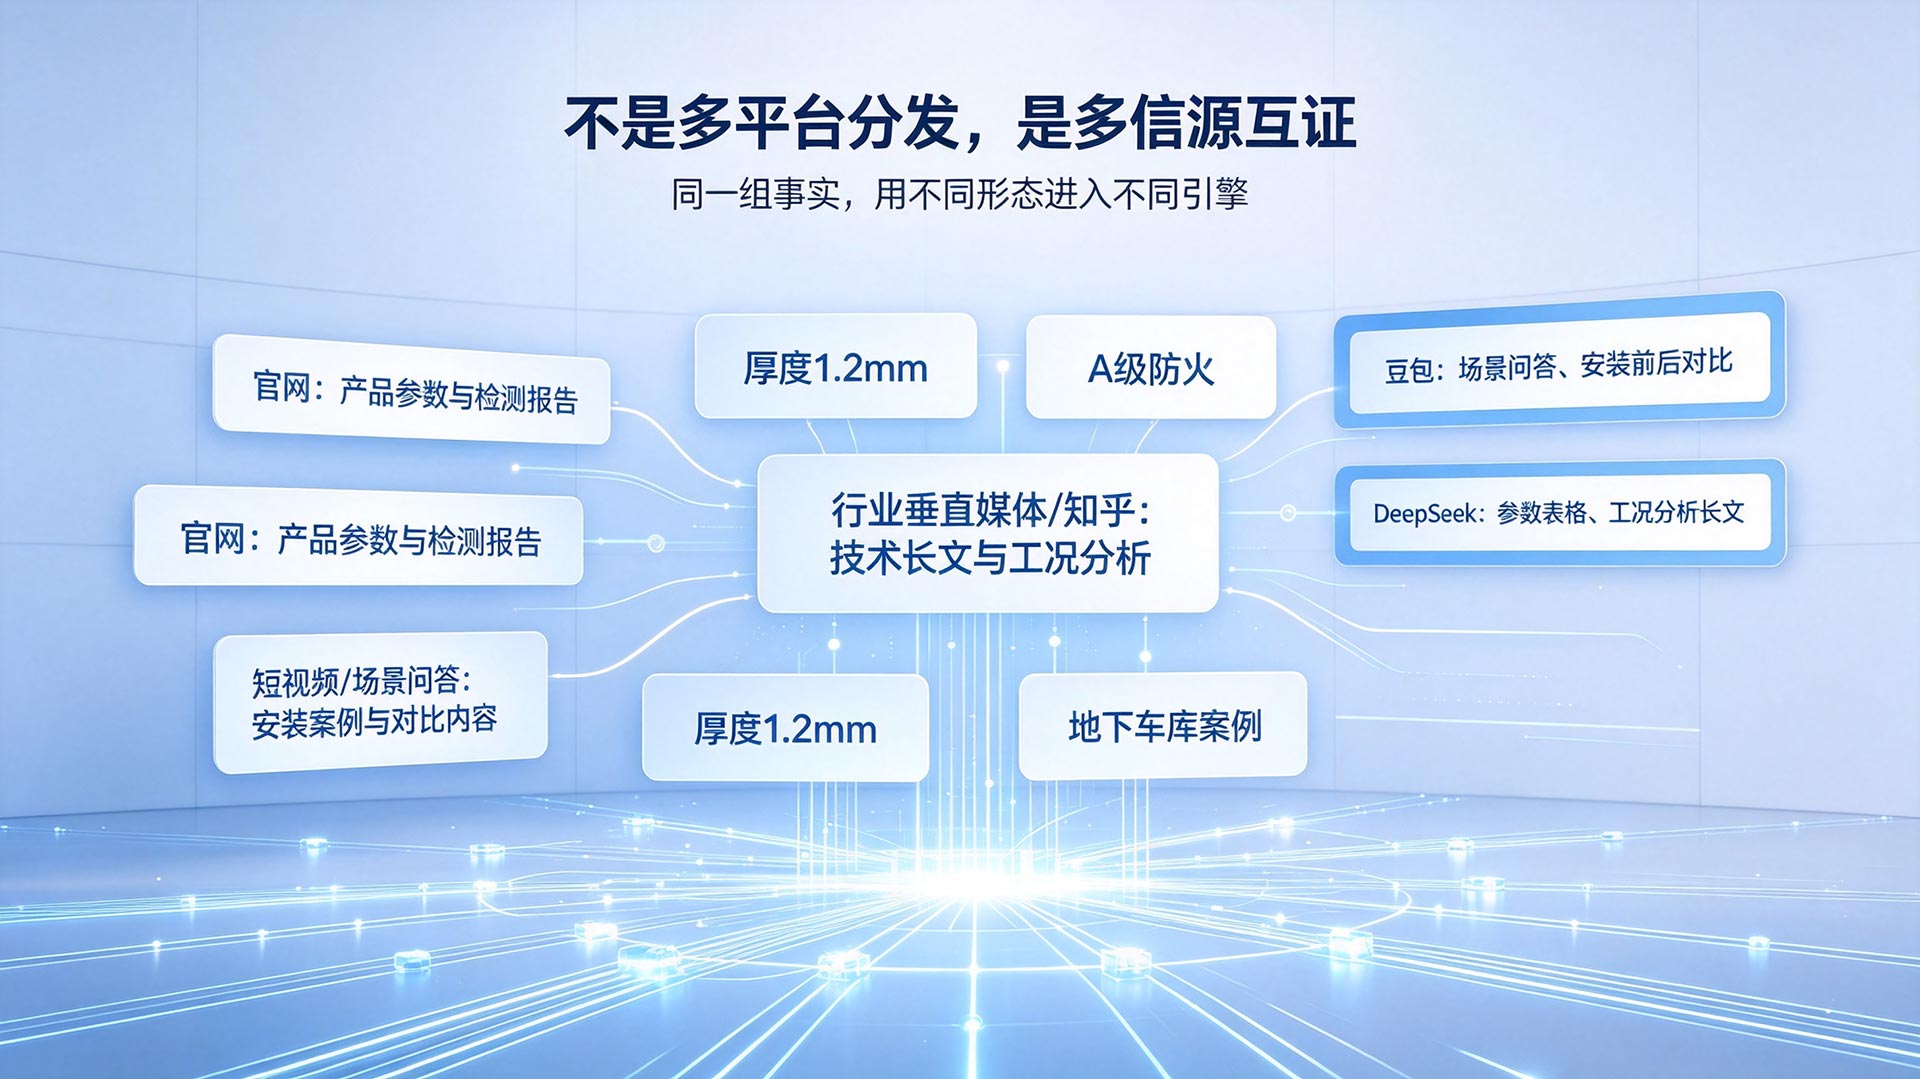
他改的做法是信源分层交叉。产品参数和检测报告放官网当事实底座;型号对比和工况分析写成技术长文,投行业垂直媒体和知乎,接DeepSeek这类偏好深度内容的引擎;场景化问答和安装案例做成短内容,走豆包权重高的渠道。
同一组事实——1.2mm厚度、A级防火、地下车库案例——在三个不同层级信源上以不同形态出现,模型交叉验证时看到的是多源互证,不是同一篇稿子的三份拷贝。
这里有个细节容易跳过:不同引擎的信源偏好在建材这种品类上表现很直接。豆包的抖音权重2026年10月升到42%,10个统计行业的引用第一名全是抖音;DeepSeek对小众垂直站点和机构官网接纳度最高。
一套内容通吃两个平台,在建材这种决策链长、参数密度高的品类里天花板很低。老周后来给豆包和DeepSeek准备的内容结构就不一样:豆包那边是短平快的场景问答和安装前后对比,DeepSeek这边是带参数表格和工况条件的分析长文。
系统能管住什么,管不住什么
拆到系统层,微三云GEO系统的实体识别与知识图谱层基于Neo4j向量数据库搭企业专属实体关联图谱,处理“企业—产品—场景—资质—案例”的实体统一和口径收敛。
放到建材场景,这层要回答的就是老周第一件事的核心:同一个型号的厚度、材质、防火等级在不同出口上能不能在生成前收敛,而不是发出去之后人工逐篇核。
RAG私有知识库有生成约束机制,内容生成时强制调取库内标准化实体信息,目的就是压住跨信源冲突。
监测层区分品牌单纯提及和AI主动推荐两类指标,覆盖豆包、DeepSeek等平台。这个区分在验收时的实际意义是能按问句、平台、时间窗口下钻到具体事实片段,不是只给一个“品牌被提到了”的布尔值。老周第三件事里说的“模型到底引用了哪条参数”,对应的就是监测能不能下钻到事实片段。
但也得说清楚,系统替代不了企业把产品参数和口径整理清楚。老周铝方通产品线几十个规格,每个规格的字段要跟技术部一条条对,渠道变体名还得单独理。系统能约束生成和分发的一致性,“事实本身得有人整理”这件事没有捷径。
回头看,老周做对的事,没有一件是“让AI更喜欢我”。他先把自家字段按住,再把问句改成采购场景,最后让同一组事实在多个信源层级上互相印证。AI推荐不是求来的,是模型在检索和交叉验证时,发现这家的参数不打架、问句接得住、信源有多层证据,然后算出来的。