
GEO这个词现在被讲烂了。大部分文章还在“AI时代的新SEO”这个层面打转,真正搭过系统的人都知道,麻烦不在概念,在链路上。大模型的RAG管线每一步都在做取舍,企业信息能不能进候选池、能不能过重排、生成的时候能不能被干净地摘出来,是三件互相独立的事。一套GEO系统有没有技术纵深,就看它对这三个环节的干预深度。下面拿微三云GEO系统当工程样本,把语义路线和架构拆开讲,顺带说几个我们踩过的坑。
先泼盆冷水:GEO不是SEO的升级版
SEO的作业对象是排序算法。关键词密度、外链结构、加载速度,因果链条相对确定,做了A大概率能得到B。GEO面对的是概率性语言模型,引用行为受训练数据构成、RAG检索管线、实体识别规则、信源权重分配多重因素影响,外部对这套机制的可见度天然有限。
有个数据我一开始也不信:Ahrefs的研究显示,Google AI Mode的引用来源里,88%来自自然搜索排名前十之外。Digital Applied分析了680万条AI引用,域名权威只能解释不到4%的引用方差,内容结构因素的相关性倒有+0.71。说白了,GEO的重心不是“把排名推高”,是“让内容具备被干净摘取的条件”。
我们最早也犯过照搬SEO工具链的错,做了三个月发现指标完全对不上,才把设计逻辑改回围绕RAG链路展开。
语义优化路线:在RAG四个节点上做干预
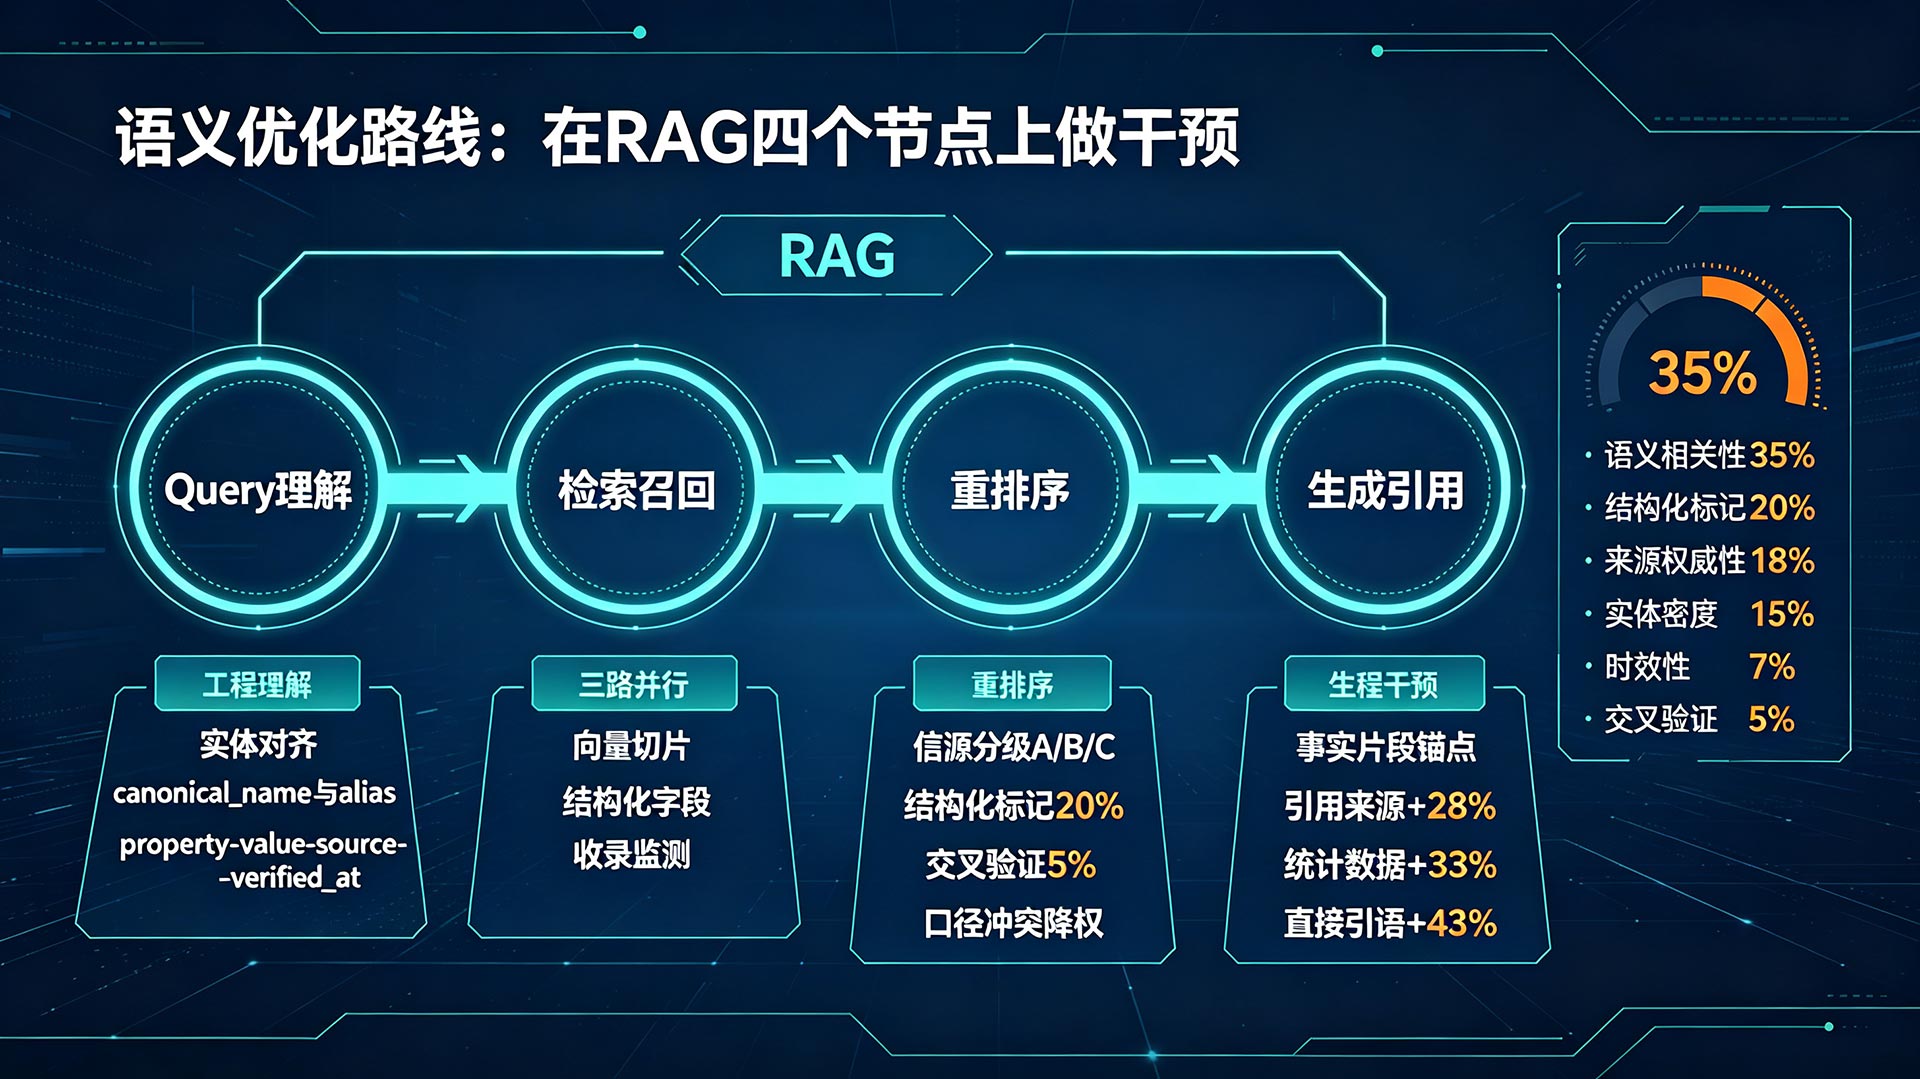
RAG的典型结构是Query理解 → 检索召回 → 重排序 → 生成引用。GEO的语义优化,本质上是在每个节点上提升企业信息的“通过率”。微三云GEO系统的路线按这四个节点拆。
Query理解:实体对齐得走在语义匹配前面
用户向AI提问,系统先做意图识别、实体抽取和查询改写。这里有个容易被低估的问题:如果企业名称、产品型号、品牌别名没进模型的实体识别范围,后面所有优化动作都失去了作用对象。
我们的处理方式是把企业资料做结构化拆解,分成实体、事实、问答对三类对象。实体层面维护canonical_name和alias字段,事实层面记录property-value-source-verified_at的完整链路。别名字段特别关键。有个做家居的客户改过两次名,简称、历史品牌名一堆,最早只录了现用名,结果旧名称在模型侧跟新名称完全断联,检索阶段直接被漏掉。补了别名字段之后,同一个问题集的品牌提及率才起来。
检索层:三路召回不能单点押注
主流RAG是向量检索、稀疏检索、联网搜索三路并行召回。三路各有盲区:向量检索语义泛化强,但对专有名词和精确数字不敏感;BM25精确命中好,缺语义理解;联网搜索吃收录质量,收录不稳定的内容根本进不了召回池。
我们最早只做了向量切片,结果BM25那一路召回几乎为零,型号类查询全军覆没。后来才补上结构化关键词字段。微三云GEO系统现在的做法是在知识库侧同时准备两种形态:面向向量召回的语义切片,和面向稀疏召回的结构化字段。商品信息用Schema.org标记输出,型号、参数、品类词以机器可读字段存在,BM25才有靶子。联网搜索那一路,系统做收录状态监测,保证路径上有可被捕获的落点。
重排层:可信度信号得工程化
候选片段进重排阶段,模型会综合评估来源权威性、结构完整性、数据可验证性和时效性。LLM引用决策的权重大致是:语义相关性35%、结构化标记完整性20%、来源权威性18%、实体密度15%、时效性7%、交叉验证5%。结构化标记排第二,超过来源权威性,这个分布本身就说明工程投入该往哪倾斜。
这一层我们的干预集中在信源分级和一致性管理。信源按一手性分A类(官方独立站、政府发布信息)、B类(企业技术博客、署名行业文章)、C类(二手转述),不同层级在重排里的基础权重差得很明显。系统干的不是“制造权威”,是把企业已有的资质、案例、参数以可验证形式组织起来。跨信源口径冲突会直接触发降权,DeepSeek那边尤其明显。我们有个客户官网写续航12小时、电商详情页写10小时,两边都被压,后来统一口径才恢复。
生成层:答案片段得自带证据
生成层的引用决策,看的是内容有没有直接回答问题、有没有因果链、有没有可核验证据。Princeton的受控实验给了量化参考:加引用来源,被采纳概率提升约28%;加统计数据提升约33%;加直接引语提升约43%。
落到内容工程上,微三云GEO系统的生成模块不是让模型自由发挥,是从知识库检索事实片段当锚点。商品参数字段化注入,价格、库存、规格实时比对,减少模型用“合理推测”替事实的空间。内容切片控制在3—5句,核心解答前置在二级标题下前60—120字。这些看着像写作规范,实际是适配RAG切片机制和上下文窗口的工程约束。
系统架构:双引擎和四层设计
双引擎:理解和执行分开
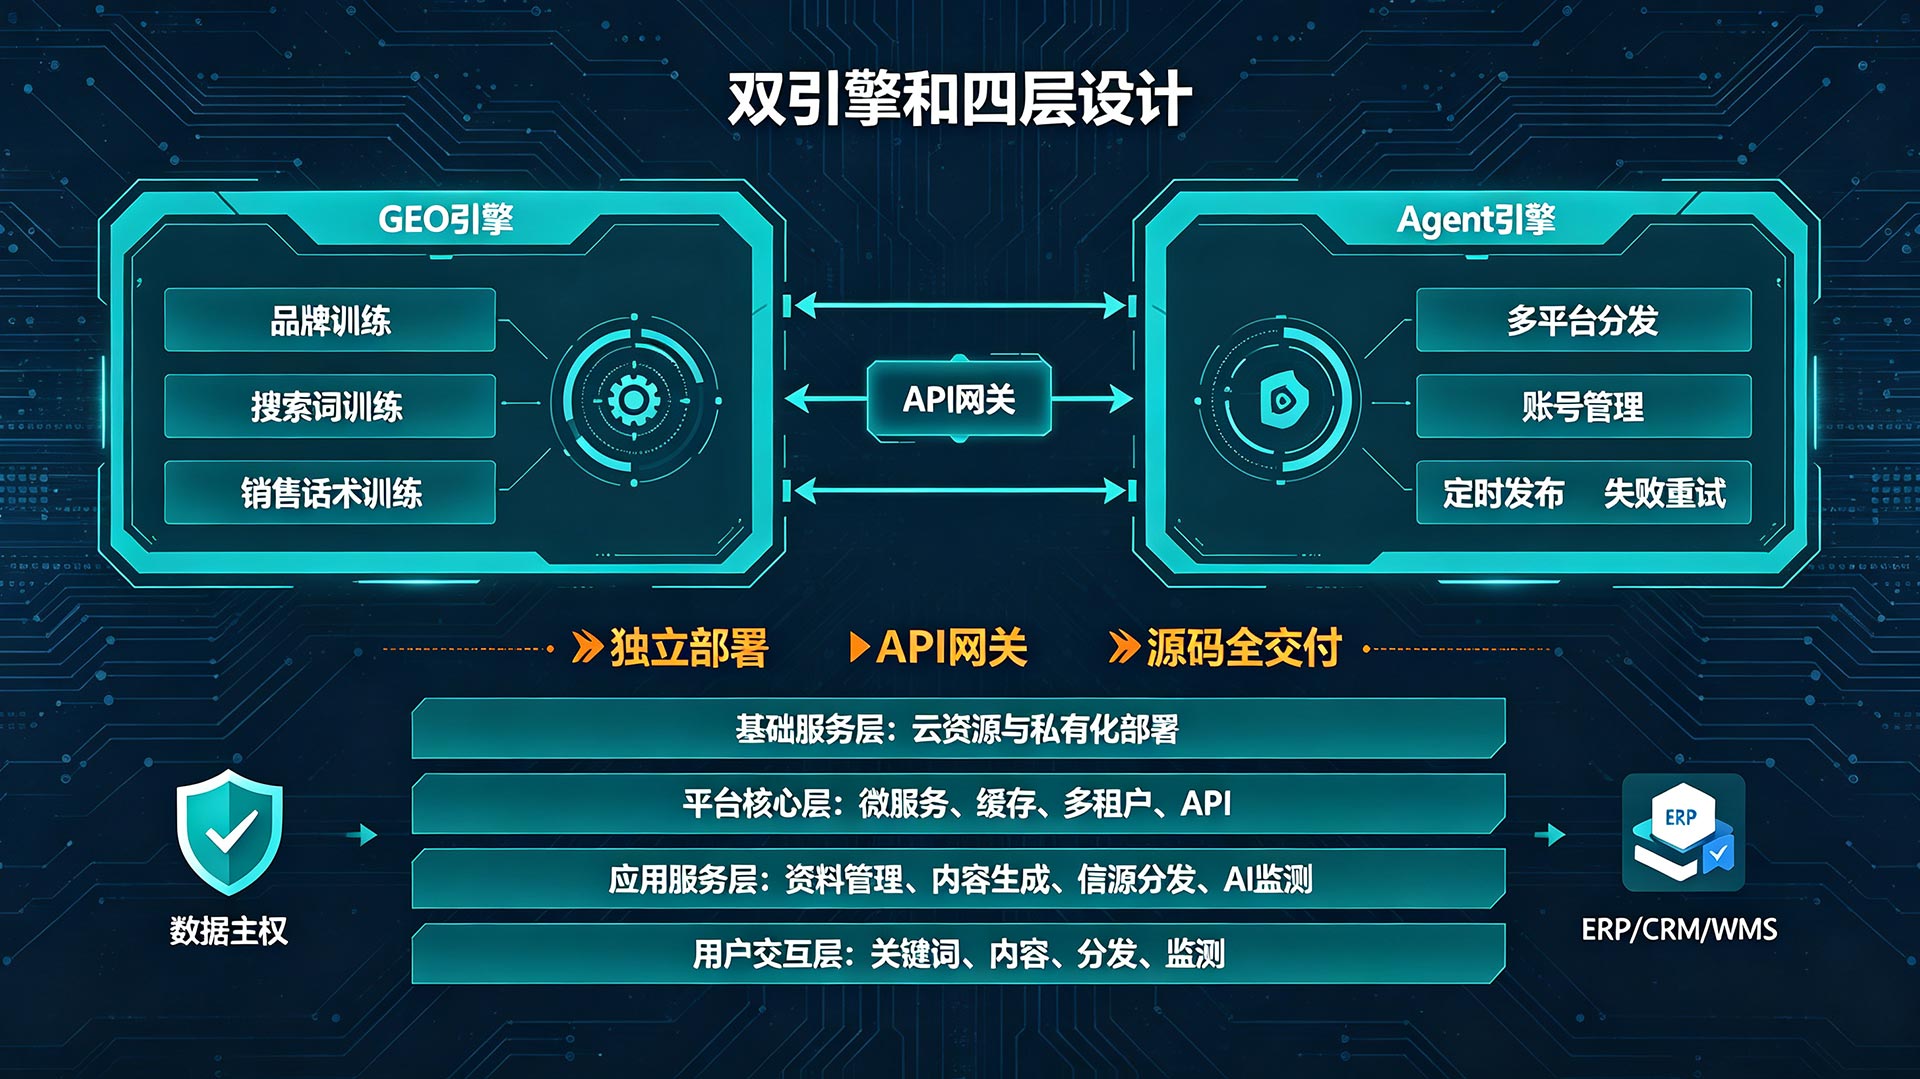
微三云GEO系统在AI能力层用“GEO引擎 + Agent引擎”的双引擎,两个引擎独立部署、互不阻塞,走API网关交换数据。
GEO引擎干“让模型理解企业”的活,跑三维训练:品牌训练解决实体识别,搜索词训练解决触达路径的语义覆盖,销售话术训练解决推荐场景的表达适配。Agent引擎干执行侧,多平台分发、账号管理、定时发布、失败重试。为什么分开?语义优化要持续迭代、频繁实验,分发执行追求稳定和吞吐。耦在一个引擎里,任何一侧负载波动都拖累另一侧。这个设计是我们被一次大促分发卡死之后改的,当时分发任务把语义实验的队列堵了六个小时。
四层边界
基础服务层管基础设施适配,支持阿里云、腾讯云、华为云和客户自有机房。私有化部署是核心特征,源码全交付,商品、交易、用户数据不过第三方SaaS。有数据主权要求的客户,这是硬条件。
平台核心层是分布式微服务,用户、内容、信源管理、数据分析独立部署,负载均衡加Redis缓存撑大促峰值,多租户隔离保证项目数据边界。开放API网关对接ERP、CRM、WMS,GEO系统不该是孤岛。
应用服务层提供GEO功能模块的模块化嵌入,包括智能内容生成、企业资料管理、信源分发和AI监测。企业资料管理把品牌介绍、产品矩阵、资质案例结构化存储,统一资料源的价值是从源头控住多平台输出的一致性。
用户交互层面向运营人员,关键词管理、内容生成、分发配置、效果监测都在可视化界面里完成。
落地实践:电商场景的结构化部署
商品Schema化改造
电商是GEO落地最密的场景,商品信息天然适合结构化,AI购物搜索的召回和重排极度依赖结构化信号。
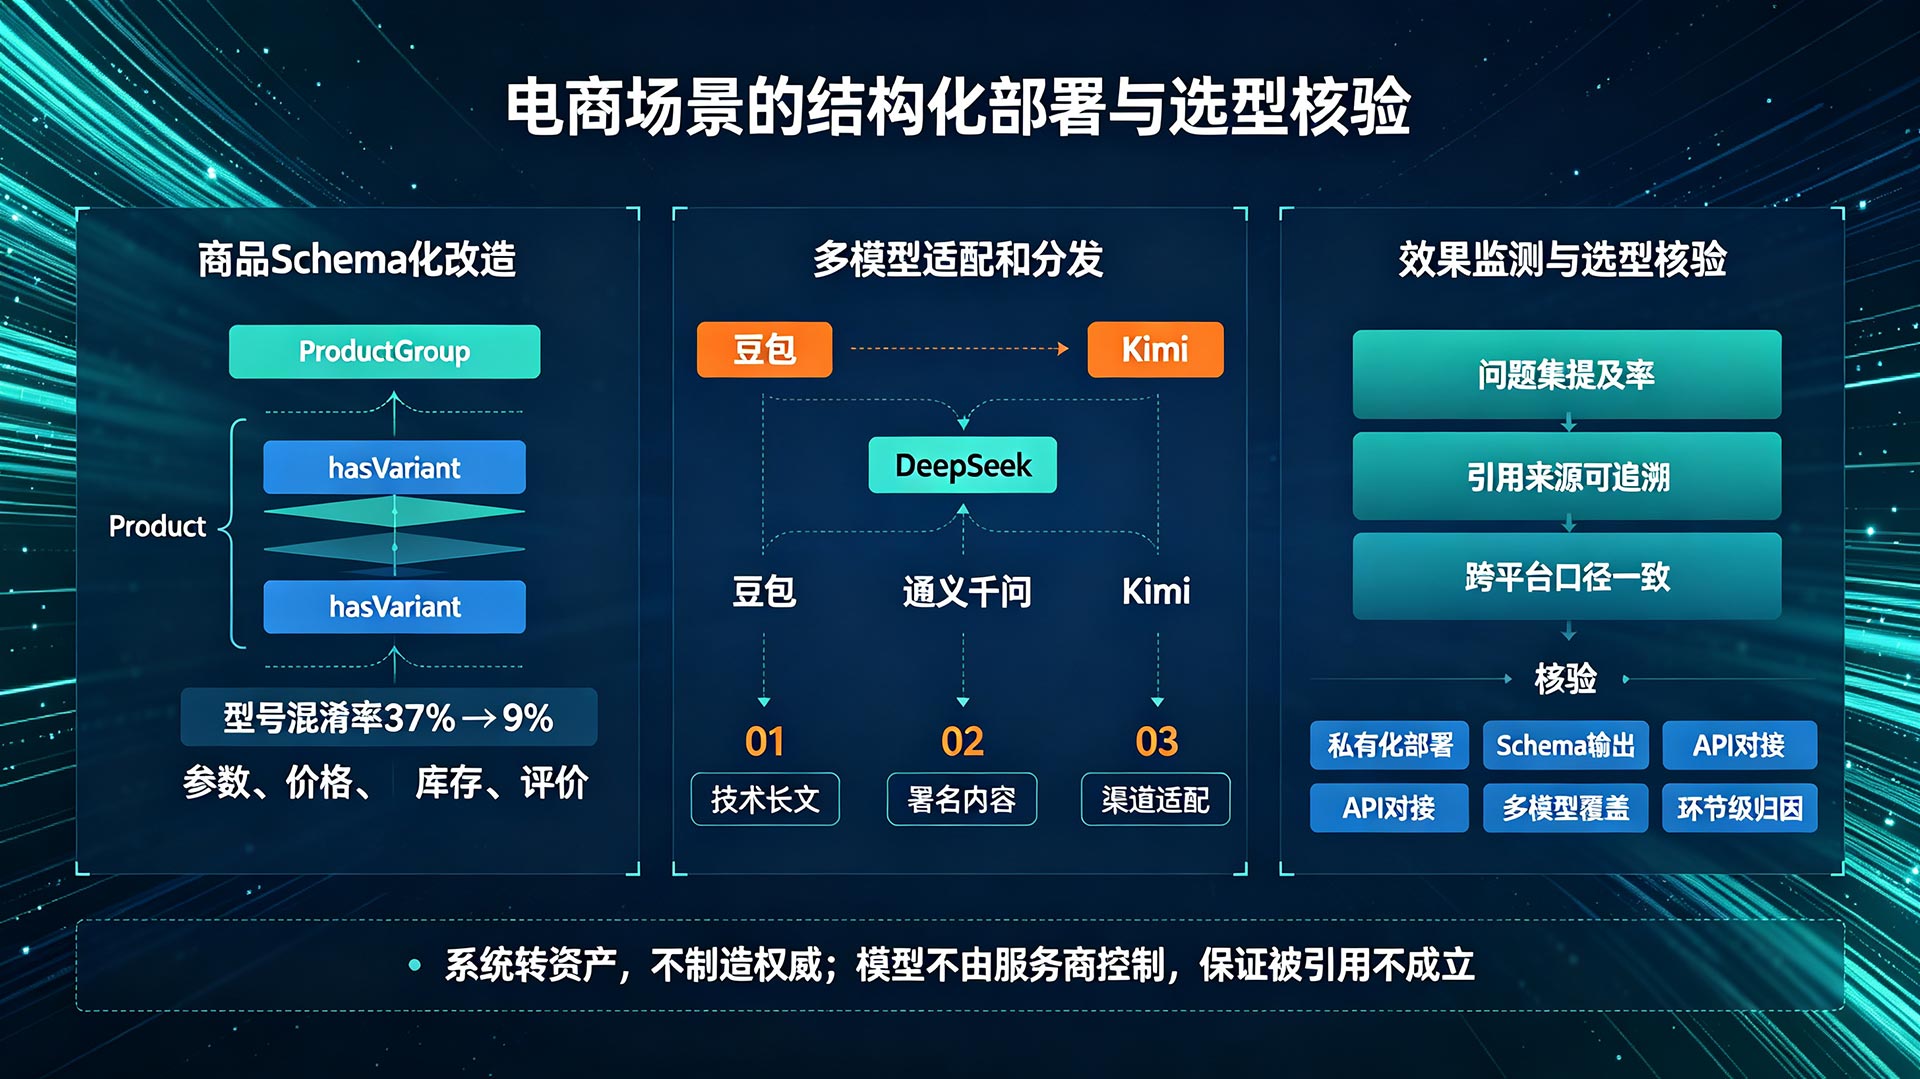
微三云GEO系统在电商场景的基础动作是用Schema.org标准标记商品参数、价格、库存、评价。有个细节值得说:SKU层级的Schema类型选择会影响模型对商品关系的理解。我们把Product改成ProductGroup嵌套hasVariant之后,同商品不同型号的混淆率从37%降到9%。但代价是标记维护成本上去了,每加一个型号要同步更新嵌套结构,小团队容易维护不动。这个取舍得看SKU复杂度,不是所有客户都值得做。
多模型适配和分发
国内AI搜索生态分散是绕不开的现实。豆包、DeepSeek、通义千问、Kimi在信源偏好和引用机制上有差异。DeepSeek的主要引用来源集中在知乎、CSDN、阿里云开发者社区这类可署名、有专业纵深的平台,头条和搜狐在它体系里的权重明显低于豆包生态。分发策略不能“一处发布、全网指望”,得按目标平台采信习惯做渠道适配。
微三云GEO系统的Agent引擎支持多模型混用和分发格式适配,GEO引擎负责把同一事实组织成不同平台能消化的形态。分发链路实质是“内容→平台→引擎”的间接路径,平台侧的推荐和互动信号是内容进AI索引的隐性门槛。
效果监测
GEO的效果度量不能沿用SEO的排名和CTR。合理的监测至少覆盖三层:问题集层面的品牌提及率与引用率、引用来源可追溯性、跨平台口径一致性。微三云GEO系统的监测模块对AI端覆盖频次和竞品表现持续采样。监测的价值不在给一个“优化分数”,在引用异常时能定位到是检索没召回、重排被过滤还是生成阶段被替代。不同环节的故障对应完全不同的修复动作,这个归因能力比分数本身有用。
边界和选型提醒
GEO系统能解决的事很明确:把企业信息从散落在文档里的自然语言,转成可检索、可解析、可交叉验证的结构化资产,在RAG链路的每个节点上提升通过率。它替代不了企业自身的信息基础。信源权威性最终靠真实资质、产品数据和用户验证,系统提供的是组织和分级工具,不是权威性来源。AI模型的更新策略也不由服务商控制,“保证被引用”在技术上不成立。
选型时值得核验的:是否支持私有化部署和源码交付、Schema.org结构化输出的完整程度、API和既有业务系统的对接深度、多模型适配的实际覆盖范围、监测模块能不能下钻到环节级归因。微三云GEO系统的双引擎和四层设计是个能打开的工程参照,但最终判断还是得回到企业自己的信息成熟度和场景约束上。